Потеря кворума контроллеров (KRaft quorum loss) — сценарий, к которому инженер Apache Kafka готовится реже всего и который сложнее всего разбирать в момент аварии. Компания Aiven, предоставляющая управляемые сервисы с открытым кодом, включая Kafka, недавно описала собственную процедуру восстановления после такого отказа. Её внутренний инструмент закрыт, поэтому повторить процедуру нельзя, зато можно разобрать механизм, который к ней ведёт. В статье мы выясним, как устроен кворум в динамическом режиме, что перестаёт работать без большинства контроллеров, и воспроизведём потерю двух контроллеров из трёх на стенде в Docker.
Что утверждает Aiven и почему кворум нельзя терять
Исходник — запись в блоге Aiven под названием Never lose quorum in Apache Kafka and what to do when you do. Все утверждения об Aiven в этой статье — пересказ исходника. Мы не сверяли их с другими источниками и на стенде не проверяли, если прямо не сказано обратное. Автор начинает с общеизвестного совета, что кворум контроллеров терять нельзя. Кворум Raft, не способный выбрать лидера, не может зафиксировать (commit) изменения метаданных. Кластер без работающего контроллера не создаёт топики, не меняет ACL и не выбирает лидеров партиций.
Дальше идёт главный тезис. В динамическом кворуме (dynamic quorum) из этого состояния нет документированного пути, и со штатными инструментами кластер остаётся остановленным неопределённо долго. Aiven пишет, что такой сценарий всегда означает потерю данных, а восстановить можно только доступность.
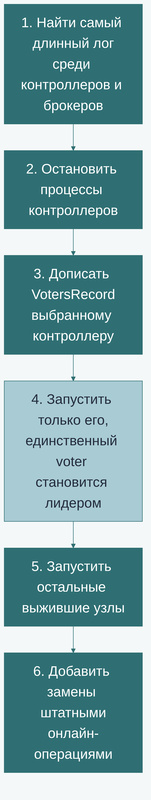
Процедура Aiven в пересказе исходника выглядит так. Нужно найти самую длинную копию лога метаданных среди выживших узлов, остановить контроллеры, офлайн дописать в лог выбранного контроллера записи VotersRecord, пока он не останется единственным голосующим участником, и запустить только его. Затем остальные узлы подхватывают новый состав, а замены добавляются обычными онлайн-операциями. Всё это Aiven делает собственным инструментом, потому что в апстриме поддерживаемого способа пока нет.
Статья Aiven остаётся рассказом одного вендора о своей практике. Утверждения о поведении брокеров при откате эпохи лидера в ней приведены без ссылок на документацию, поэтому мы будем отмечать, что подтверждено первоисточником, а что взято только из исходника.
Как устроен кворум KRaft
Чтобы понять, почему из потери большинства нельзя выйти штатными средствами, нужно разобраться, где хранится состав голосующих узлов.
Статический и динамический кворум
В статическом режиме состав голосующих участников (voters) задаётся параметром controller.quorum.voters в конфигурации каждого узла. По описанию в KIP-853 (Kafka Improvement Proposal, предложение по улучшению Kafka), чтобы изменить этот состав, приходилось останавливать все контроллеры и вручную править состояние на диске старых и новых узлов.
KIP-853 переносит состав в сам лог метаданных. Он хранится в управляющих записях (control records) типа VotersRecord, а также в снапшотах. Наблюдатели (observers), то есть брокеры, узнают текущий состав, реплицируя тот же лог. Каждый голосующий узел определяется парой из идентификатора реплики и directory ID — UUID, который создаётся при форматировании каталога командой kafka-storage.sh format и сохраняется в служебном файле метаданных каталога.
Отсюда следует важное свойство. Новый диск под старым именем узла получает новый directory ID и поэтому является новой репликой, а не переименованной старой. Это подтверждает и сценарий восстановления после отказа диска в KIP-853, где новая реплика сначала появляется среди наблюдателей и только потом добавляется в состав, а старая удаляется.
Для онлайн-смены состава в KIP-853 описаны RPC AddVoter и RemoveVoter, а в командной строке — команды add-controller и remove-controller утилиты kafka-metadata-quorum.sh. Лидер принимает только одну смену состава за раз. Запись VotersRecord должна быть зафиксирована большинством нового состава, и лишь затем лидер берётся за следующую. Именно это делает смену безопасной, и именно это делает её невозможной без большинства.
High watermark и почему он должен замирать
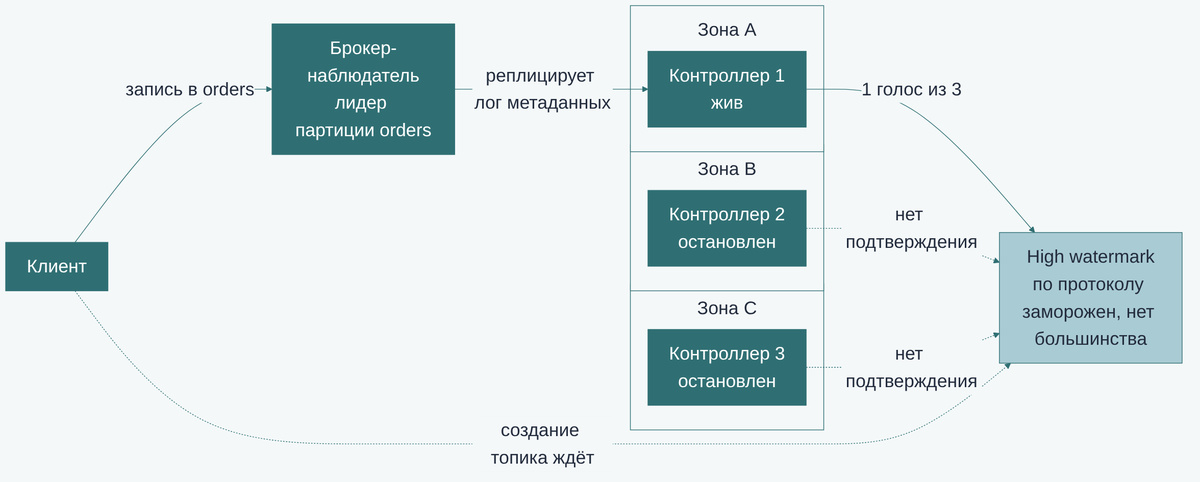
Лидер считает запись зафиксированной, когда её подтвердило большинство голосующих узлов. Позицию, до которой записи зафиксированы, называют high watermark (HWM). В трёхузловом кворуме большинство равно двум, поэтому по протоколу при остановке двух контроллеров лидер не может подвинуть HWM, а оставшийся узел не может выиграть выборы. Это вывод из протокола, а не результат нашего прогона. Мы пытались прочитать HWM после остановки командой describe —status, но ответа не получили, так что замирание HWM на стенде не наблюдалось. Рост HWM остаётся разумным признаком живого кворума, и на него стоит ставить оповещение дежурному, но проверять эту метрику нужно отдельно.
Петля зависимостей, о которой говорит исходник, получается такой. Чтобы убрать потерянных голосующих, нужно зафиксировать смену состава. Чтобы её зафиксировать, нужно большинство. Чтобы получить большинство, нужно убрать потерянных. Штатные операции AddVoter и RemoveVoter (команды add-controller и remove-controller) в этой ситуации, судя по протоколу из KIP-853, должны отказывать, потому что смена состава требует фиксации большинством. Это вывод из описания протокола, на стенде мы его не проверяли.
Что ломается и что продолжает работать при потере большинства
Различать нужно две плоскости. Плоскость управления (control plane) — это всё, что меняет метаданные, а плоскость данных (data plane) — это запись и чтение в уже существующие партиции.
К плоскости управления относятся создание топиков, изменение ACL, выбор лидеров партиций и любые изменения состава реплик. Все они проходят через активный контроллер и требуют зафиксированной записи в логе метаданных. Поэтому по протоколу они не должны завершаться без большинства. На стенде мы видели это для создания топика, которое закончилось таймаутом.
С плоскостью данных всё менее однозначно. Можно предположить, что брокер, остающийся лидером своей партиции, продолжает принимать записи, пока ему не нужно менять ISR (in-sync replicas, набор синхронных реплик), потому что изменение ISR тоже проходит через контроллер. Прогон проверил только узкий случай. Это один брокер, одна партиция и фактор репликации 1, где ISR состоит из единственной реплики и не меняется. Сценарии со сменой ISR прогон не затрагивал, поэтому рассуждение про ISR остаётся непроверенным. Исходник Aiven этот вопрос не раскрывает, он честно оговаривает, что потеря данных партиций зависит от числа брокеров, фактора репликации и от того, дошло ли последнее сообщение до выжившей реплики.
Практический вывод для мониторинга простой. Здоровье кластера нужно проверять двумя независимыми пробами, одной на запись и одной на изменение метаданных, потому что по одной только записи потерю кворума можно не заметить.
Как выбрать лучшую уцелевшую копию лога
Раздел описывает логику Aiven, а не поддерживаемую процедуру Apache Kafka, и всё в нём — пересказ исходника, который мы не проверяли. По исходнику, лог метаданных реплицируют и контроллеры, и брокеры, поэтому брокер-наблюдатель может иметь больший LogEndOffset, чем любой выживший контроллер. Брать нужно самую длинную копию, включая копии брокеров.
Причина названа в исходнике. Брокеры, по словам Aiven, не умеют корректно переживать уменьшение эпохи лидера, значит, восстановленный лог должен содержать все метаданные, которые брокеры уже видели. Если собрать кластер из более короткого лога, брокеру придётся «забыть» запись, которую он уже наблюдал. Цена выбора очевидна. Всё, что находилось после выбранного оффсета только на потерянных дисках, возвращается навсегда недоступным. Aiven прямо называет это выбором доступности вместо тёмного кластера.
Пока лидер жив, длину логов можно увидеть командой kafka-metadata-quorum.sh describe —replication, она показывает LogEndOffset голосующих и наблюдателей. Когда лидера нет, остаётся читать файлы лога напрямую утилитой kafka-dump-log.sh и сравнивать последние оффсеты. Дописывание VotersRecord — офлайн-правка лога Raft, в апстриме для неё нет поддерживаемого инструмента, и мы её на стенде не выполняем.
Профилактика и сравнение режимов управления кворумом
Aiven формулирует профилактику коротко. Потеря кворума редка, если голосующие распределены по доменам отказа и замена узлов никогда не убирает большинство одновременно. На практике это три правила.
- Размер кворума. Три голосующих узла переносят потерю одного, пять переносят потерю двух. Aiven пишет, что обычно используется три, на крупных развёртываниях иногда пять.
- Домены отказа. Голосующие размещаются по разным зонам доступности. Потеря целой зоны при трёх голосующих в трёх зонах оставляет большинство. Исходник особо замечает, что голосующих меньше, чем узлов, и потеря двух контроллеров не равна потере двух третей узлов сервиса.
- Порядок замены. Сначала новый узел форматируется и добавляется как наблюдатель, затем становится голосующим, и только потом удаляется старый. Именно в таком порядке устроены сценарии замены узла и диска в KIP-853.
Эти правила дешевле любого восстановления, потому что после потери большинства выбирать остаётся только между разными формами потери данных. Практики эксплуатации кластера по этой теме подробно разбираются на курсе Администрирование кластера Kafka.
Теперь сведём в таблицу режимы управления кворумом. Строки, где указано «по Aiven», опираются только на пересказ исходника и нами не проверялись. Страница KIP-1347 на вики Kafka при нашей проверке вернула 404, поэтому строка про него целиком держится на Aiven.
| Режим | Где хранится состав голосующих | Смена состава онлайн | При потере большинства | Поддержка в штатных инструментах |
|---|---|---|---|---|
| Статический (controller. |
В конфигурации узлов (KIP-853) | Нет, нужно остановить все контроллеры и править состояние на диске (KIP-853) | Правка параметра и перезапуск (по Aiven) | Да |
| Динамический (KIP-853) | В логе метаданных и снапшотах, запись VotersRecord | Да, через AddVoter и RemoveVoter, команды add-controller и remove-controller | Штатные RPC должны отказывать (вывод из протокола KIP-853, по Aiven кластер остаётся остановленным) | Да, для штатных смен состава |
| Предложение —override-voters (KIP-1347) | В логе, но снапшот на конце локального лога подменяет адреса (по Aiven) | Нет, офлайн через kafka-storage.sh format (по Aiven) | Не покрывает, целевой случай — устаревшие адреса голосующих (по Aiven) | Нет, предложение обсуждается (по Aiven) |
| Ручное дописывание VotersRecord | В логе метаданных | Нет, офлайн при остановленных контроллерах | Возвращает доступность ценой потери суффикса лога, которого нет на выживших узлах (по Aiven) | Нет, у Aiven закрытый инструмент |
Статический режим проще выводить из аварии, но он не позволяет менять состав без остановки. Динамический режим, по рассуждению Aiven, безопаснее в повседневной работе и жёстче в аварии, потому что лог остаётся единственным источником правды, а выжившие процессы продолжают ждать узлы, которые лог по-прежнему считает голосующими. Это пересказ исходника, на стенде мы его не проверяли, и наш прогон показал лишь возврат контроллеров с сохранёнными дисками. KIP-1347, по пересказу Aiven, решает соседнюю задачу. Он лечит неверные адреса при верном составе, а не лишние голосующие узлы, и переписывает историю, создавая снапшот, расходящийся с логом. Ручное дописывание записей, по описанию Aiven, остаётся единственным путём возврата доступности, но выполнять его стоит только когда подтверждено, что потерянных голосующих вернуть нельзя.
Схема ниже показывает, что происходит на стенде, к которому мы переходим.
Последовательность восстановления по описанию Aiven показана на второй схеме.
Практика, потеря двух контроллеров из трёх на стенде
Стенд состоит из трёх отдельных контроллеров по 512 МБ и одного брокера на 1 ГБ, всего 2,5 ГБ. Контроллер 1 форматируется с флагом —standalone и становится единственным голосующим узлом. Контроллеры 2 и 3 стартуют как наблюдатели и вступают в кворум сами благодаря параметру controller.quorum.auto.join.enable, который описан в KIP-853. Порт наружу открыт только у брокера и только на 127.0.0.1. Брокер единственный, а фактор репликации равен 1, поэтому проверка записи в существующий топик здесь не зависит от репликации. На кластере с репликацией и ISR поведение может отличаться, этого стенд не проверяет.
Версию клиента confluent-kafka 2.6.1 мы оставили той, на которой стенд прогонялся, и обновление версии не проверяли. Для двух вызовов Producer и AdminClient этого достаточно.
Начнём с файла compose.yaml.
# compose.yaml · apache/kafka 4.3.2 · KRaft, динамический кворум
services:
  controller1:
    image: apache/kafka:4.3.2
    mem_limit: 512m
    command: ["bash", "/scripts/start.sh"]
    environment:
      ROLE: controller
      NODE_ID: "1"
      STANDALONE: "1"
      KAFKA_HEAP_OPTS: "-Xmx256m -Xms256m"
    volumes:
      - ./start.sh:/scripts/start.sh:ro

  controller2:
    image: apache/kafka:4.3.2
    mem_limit: 512m
    command: ["bash", "/scripts/start.sh"]
    environment:
      ROLE: controller
      NODE_ID: "2"
      AUTO_JOIN: "true"
      KAFKA_HEAP_OPTS: "-Xmx256m -Xms256m"
    volumes:
      - ./start.sh:/scripts/start.sh:ro
    depends_on:
      - controller1

  controller3:
    image: apache/kafka:4.3.2
    mem_limit: 512m
    command: ["bash", "/scripts/start.sh"]
    environment:
      ROLE: controller
      NODE_ID: "3"
      AUTO_JOIN: "true"
      KAFKA_HEAP_OPTS: "-Xmx256m -Xms256m"
    volumes:
      - ./start.sh:/scripts/start.sh:ro
    depends_on:
      - controller1

  broker:
    image: apache/kafka:4.3.2
    mem_limit: 1g
    command: ["bash", "/scripts/start.sh"]
    environment:
      ROLE: broker
      NODE_ID: "4"
      KAFKA_HEAP_OPTS: "-Xmx512m -Xms512m"
    ports:
      - "127.0.0.1:29092:29092"
    volumes:
      - ./start.sh:/scripts/start.sh:ro
    depends_on:
      - controller1
Скрипт start.sh собирает конфигурацию по роли, один раз форматирует каталог и запускает сервер. Повторный запуск остановленного контейнера пропускает форматирование, поэтому узел возвращается с тем же directory ID.
# start.sh · apache/kafka 4.3.2
set -euo pipefail
DATA=/var/lib/kafka/data
CONF=/tmp/server.properties
BIN=/opt/kafka/bin
CID=MkU3OEVBNTcwNTJENDM2Qk

if [ "$ROLE" = "controller" ]; then
cat > "$CONF" <<EOF
process.roles=controller
node.id=${NODE_ID}
log.dirs=${DATA}
listeners=CONTROLLER://:9093
controller.listener.names=CONTROLLER
listener.security.protocol.map=CONTROLLER:PLAINTEXT
controller.quorum.bootstrap.servers=controller1:9093
controller.quorum.auto.join.enable=${AUTO_JOIN:-false}
EOF
  FORMAT_ARGS="--no-initial-controllers"
  if [ "${STANDALONE:-0}" = "1" ]; then
    FORMAT_ARGS="--standalone"
  fi
else
cat > "$CONF" <<EOF
process.roles=broker
node.id=${NODE_ID}
log.dirs=${DATA}
listeners=PLAINTEXT://:9092,EXTERNAL://:29092
advertised.listeners=PLAINTEXT://broker:9092,EXTERNAL://127.0.0.1:29092
listener.security.protocol.map=PLAINTEXT:PLAINTEXT,EXTERNAL:PLAINTEXT,CONTROLLER:PLAINTEXT
inter.broker.listener.name=PLAINTEXT
controller.listener.names=CONTROLLER
controller.quorum.bootstrap.servers=controller1:9093,controller2:9093,controller3:9093
offsets.topic.replication.factor=1
transaction.state.log.replication.factor=1
transaction.state.log.min.isr=1
EOF
  FORMAT_ARGS=""
fi

if [ ! -f "$DATA/meta.properties" ]; then
  $BIN/kafka-storage.sh format --cluster-id "$CID" $FORMAT_ARGS --config "$CONF"
fi
exec $BIN/kafka-server-start.sh "$CONF"
Клиентские зависимости минимальны.
# requirements.txt
confluent-kafka==2.6.1
Вспомогательный скрипт quorum.sh вызывает kafka-metadata-quorum.sh внутри контроллеров и перебирает их по очереди. Это нужно, потому что после остановки двух узлов ответить может только оставшийся, а на стенде мы заранее не знаем, какой из них лидер.
# quorum.sh · kafka-metadata-quorum.sh · Kafka 4.3.2
set -uo pipefail
cd "$(dirname "$0")"
for c in controller1 controller2 controller3; do
  if timeout 25 docker compose exec -T "$c" /opt/kafka/bin/kafka-metadata-quorum.sh --bootstrap-controller "$c:9093" "$@" 2>/dev/null; then
    exit 0
  fi
done
echo "ни один контроллер не ответил на $*"
exit 1
Скрипт probe.py реализует две пробы. Проба данных пишет пять сообщений в существующий топик orders с acks=all. Проба управления пытается создать новый топик с уникальным именем и ждёт ответа с таймаутом. Пробы вынесены в функции, чтобы потом переиспользовать их в задании.
# probe.py · confluent-kafka 2.6.1 · Kafka 4.3.2
import time
from concurrent.futures import TimeoutError as FutureTimeout

from confluent_kafka import KafkaException, Producer
from confluent_kafka.admin import AdminClient, NewTopic

BOOTSTRAP = "127.0.0.1:29092"


def data_plane(topic="orders", count=5):
    delivered = []
    errors = []

    def on_delivery(err, msg):
        if err:
            errors.append(err.name())
        else:
            delivered.append(msg.offset())

    producer = Producer({
        "bootstrap.servers": BOOTSTRAP,
        "acks": "all",
        "message.timeout.ms": 10000,
    })
    for i in range(count):
        producer.produce(topic, value=f"probe-{i}".encode(), callback=on_delivery)
    producer.flush(15)
    return len(delivered), errors


def control_plane(timeout=15):
    admin = AdminClient({"bootstrap.servers": BOOTSTRAP})
    name = f"probe-{int(time.time())}"
    futures = admin.create_topics(
        [NewTopic(name, num_partitions=1, replication_factor=1)],
        operation_timeout=8,
        request_timeout=10,
    )
    try:
        futures[name].result(timeout=timeout)
        return "OK", name
    except KafkaException as e:
        return e.args[0].name(), name
    except FutureTimeout:
        return "TIMEOUT", name


if __name__ == "__main__":
    ok, errs = data_plane()
    print(f"data plane: доставлено {ok} из 5, ошибки {errs}")
    status, name = control_plane()
    print(f"control plane: create_topics {name} -> {status}")
Основной пример run.sh поднимает стенд, ставит зависимости в виртуальное окружение, ждёт, пока оба контроллера вступят в кворум, создаёт топик orders и запускает обе пробы на здоровом кластере.
# run.sh · Docker Compose · confluent-kafka 2.6.1 · Kafka 4.3.2
set -euo pipefail
cd "$(dirname "$0")"

docker compose up -d
python3 -m venv .venv
.venv/bin/pip install -q -r requirements.txt

for i in $(seq 1 30); do
  n=$(bash quorum.sh describe --replication 2>/dev/null | grep -c Follower || true)
  if [ "$n" -ge 2 ]; then break; fi
  sleep 3
done

for i in $(seq 1 30); do
  if docker compose exec -T broker /opt/kafka/bin/kafka-topics.sh --bootstrap-server broker:9092 --create --if-not-exists --topic orders --partitions 1 --replication-factor 1; then
    break
  fi
  sleep 3
done

bash quorum.sh describe --status || true
bash quorum.sh describe --replication || true
.venv/bin/python probe.py
 Network sat-kafka-15_default  Creating
 Network sat-kafka-15_default  Created
 Container sat-kafka-15-controller1-1  Creating
 Container sat-kafka-15-controller1-1  Created
 Container sat-kafka-15-controller3-1  Creating
 Container sat-kafka-15-controller2-1  Creating
 Container sat-kafka-15-broker-1  Creating
 Container sat-kafka-15-broker-1  Created
 Container sat-kafka-15-controller2-1  Created
 Container sat-kafka-15-controller3-1  Created
 Container sat-kafka-15-controller1-1  Starting
 Container sat-kafka-15-controller1-1  Started
 Container sat-kafka-15-broker-1  Starting
 Container sat-kafka-15-controller2-1  Starting
 Container sat-kafka-15-controller3-1  Starting
 Container sat-kafka-15-broker-1  Started
 Container sat-kafka-15-controller3-1  Started
 Container sat-kafka-15-controller2-1  Started
Created topic orders.
ClusterId:              MkU3OEVBNTcwNTJENDM2Qk
LeaderId:               1
LeaderEpoch:            1
HighWatermark:          53
MaxFollowerLag:         0
MaxFollowerLagTimeMs:   0
CurrentVoters:          [{"id": 1, "directoryId": "eqL2BFaoQzKeHB9CPnbXvQ", "endpoints": ["CONTROLLER://9d6db4830887:9093"]}, {"id": 2, "directoryId": "BSdRjyFXgdLGxMPDT_OfcA", "endpoints": ["CONTROLLER://7d8817ee1088:9093"]}, {"id": 3, "directoryId": "Hmjhw26jBGwXpbOnKRbUZw", "endpoints": ["CONTROLLER://468c8b6e7110:9093"]}]
CurrentObservers:       [{"id": 4, "directoryId": "f4odYCAZ-JrzLrgK4gGEaA"}]
NodeId	DirectoryId           	LogEndOffset	Lag	LastFetchTimestamp	LastCaughtUpTimestamp	Status
1     	eqL2BFaoQzKeHB9CPnbXvQ	58          	0  	1793520419658     	1793520419658        	Leader
2     	BSdRjyFXgdLGxMPDT_OfcA	58          	0  	1793520419289     	1793520419289        	Follower
3     	Hmjhw26jBGwXpbOnKRbUZw	58          	0  	1793520419286     	1793520419286        	Follower
4     	f4odYCAZ-JrzLrgK4gGEaA	58          	0  	1793520419282     	1793520419282        	Observer
data plane: доставлено 5 из 5, ошибки []
control plane: create_topics probe-1793520421 -> OK
В этом выводе видны идентификаторы голосующих, их directory ID и LogEndOffset. Это базовая линия, с которой мы будем сравнивать состояние после отказа.
Теперь сама авария. Скрипт dump_voters.sh читает файлы метаданных контроллера утилитой kafka-dump-log.sh с флагом —cluster-metadata-decoder и оставляет строки со словом voters. Он читает сразу и файлы снапшотов, и файлы лога, потому что начальный состав и последующие добавления могут лежать в разных местах. Вывод при этом не подписывает, из какого файла пришла каждая строка.
# dump_voters.sh · kafka-dump-log.sh · Kafka 4.3.2
set -uo pipefail
cd "$(dirname "$0")"
NODE=${1:-controller1}
docker compose exec -T "$NODE" bash -c '
D=/var/lib/kafka/data/__cluster_metadata-0
FILES=$(ls $D/*.log $D/*.checkpoint | paste -sd, -)
/opt/kafka/bin/kafka-dump-log.sh --cluster-metadata-decoder --files "$FILES"
' | grep -i voters || echo "записей с voters не найдено"
Скрипт lose_quorum.sh останавливает контроллеры 2 и 3, проверяет обе плоскости сразу и через 30 секунд, чтобы учесть таймауты сессий брокера, затем пытается получить состояние кворума и показывает записи VotersRecord. В конце он запускает остановленные контроллеры обратно. Диски при этом сохраняются, поэтому возвращаются те же голосующие с теми же directory ID. В нашем прогоне диски остались на месте, поэтому восстановление свелось к запуску контроллеров. С этим случаем полезно сравнивать описанную выше аварию с утраченными дисками.
# lose_quorum.sh · Docker Compose · confluent-kafka 2.6.1 · Kafka 4.3.2
set -euo pipefail
cd "$(dirname "$0")"

echo "== останавливаем controller2 и controller3"
docker compose stop controller2 controller3
sleep 5
echo "== проба сразу после остановки"
.venv/bin/python probe.py
echo "== проба через 30 секунд"
sleep 30
.venv/bin/python probe.py
echo "== describe --status"
bash quorum.sh describe --status || true
echo "== записи о voters в метаданных controller1"
bash dump_voters.sh controller1 || true

echo "== возвращаем контроллеры"
docker compose start controller2 controller3
for i in $(seq 1 30); do
  n=$(bash quorum.sh describe --replication 2>/dev/null | grep -c Follower || true)
  if [ "$n" -ge 2 ]; then break; fi
  sleep 3
done
bash quorum.sh describe --replication || true
.venv/bin/python probe.py
== останавливаем controller2 и controller3
 Container sat-kafka-15-controller3-1  Stopping
 Container sat-kafka-15-controller2-1  Stopping
 Container sat-kafka-15-controller2-1  Stopped
 Container sat-kafka-15-controller3-1  Stopped
== проба сразу после остановки
data plane: доставлено 5 из 5, ошибки []
control plane: create_topics probe-1793520427 -> _TIMED_OUT
== проба через 30 секунд
data plane: доставлено 5 из 5, ошибки []
control plane: create_topics probe-1793520467 -> _TIMED_OUT
== describe --status
ни один контроллер не ответил на describe --status
== записи о voters в метаданных controller1
| offset: 2 CreateTime: 1793520391747 keySize: 4 valueSize: 55 sequence: -1 headerKeys: [] KRaftVoters {"version":0,"voters":[{"voterId":1,"voterDirectoryId":"eqL2BFaoQzKeHB9CPnbXvQ","endpoints":[{"name":"CONTROLLER","host":"localhost","port":9093}],"kRaftVersionFeature":{"minSupportedVersion":0,"maxSupportedVersion":1}}]}
| offset: 0 CreateTime: 1793520400282 keySize: 4 valueSize: 19 sequence: -1 headerKeys: [] LeaderChange: {"version":0,"leaderId":1,"voters":[{"voterId":1}],"grantingVoters":[{"voterId":1}]}
| offset: 2 CreateTime: 1793520400282 keySize: 4 valueSize: 58 sequence: -1 headerKeys: [] KRaftVoters {"version":0,"voters":[{"voterId":1,"voterDirectoryId":"eqL2BFaoQzKeHB9CPnbXvQ","endpoints":[{"name":"CONTROLLER","host":"9d6db4830887","port":9093}],"kRaftVersionFeature":{"minSupportedVersion":0,"maxSupportedVersion":1}}]}
| offset: 27 CreateTime: 1793520405857 keySize: 4 valueSize: 112 sequence: -1 headerKeys: [] KRaftVoters {"version":0,"voters":[{"voterId":1,"voterDirectoryId":"eqL2BFaoQzKeHB9CPnbXvQ","endpoints":[{"name":"CONTROLLER","host":"9d6db4830887","port":9093}],"kRaftVersionFeature":{"minSupportedVersion":0,"maxSupportedVersion":1}},{"voterId":3,"voterDirectoryId":"Hmjhw26jBGwXpbOnKRbUZw","endpoints":[{"name":"CONTROLLER","host":"468c8b6e7110","port":9093}],"kRaftVersionFeature":{"minSupportedVersion":0,"maxSupportedVersion":1}}]}
| offset: 29 CreateTime: 1793520406326 keySize: 4 valueSize: 166 sequence: -1 headerKeys: [] KRaftVoters {"version":0,"voters":[{"voterId":1,"voterDirectoryId":"eqL2BFaoQzKeHB9CPnbXvQ","endpoints":[{"name":"CONTROLLER","host":"9d6db4830887","port":9093}],"kRaftVersionFeature":{"minSupportedVersion":0,"maxSupportedVersion":1}},{"voterId":2,"voterDirectoryId":"BSdRjyFXgdLGxMPDT_OfcA","endpoints":[{"name":"CONTROLLER","host":"7d8817ee1088","port":9093}],"kRaftVersionFeature":{"minSupportedVersion":0,"maxSupportedVersion":1}},{"voterId":3,"voterDirectoryId":"Hmjhw26jBGwXpbOnKRbUZw","endpoints":[{"name":"CONTROLLER","host":"468c8b6e7110","port":9093}],"kRaftVersionFeature":{"minSupportedVersion":0,"maxSupportedVersion":1}}]}
== возвращаем контроллеры
 Container sat-kafka-15-controller3-1  Starting
 Container sat-kafka-15-controller2-1  Starting
 Container sat-kafka-15-controller3-1  Started
 Container sat-kafka-15-controller2-1  Started
NodeId	DirectoryId           	LogEndOffset	Lag	LastFetchTimestamp	LastCaughtUpTimestamp	Status
1     	eqL2BFaoQzKeHB9CPnbXvQ	120         	0  	1793520535100     	1793520535100        	Leader
2     	BSdRjyFXgdLGxMPDT_OfcA	120         	0  	1793520534687     	1793520534687        	Follower
3     	Hmjhw26jBGwXpbOnKRbUZw	120         	0  	1793520534687     	1793520534687        	Follower
4     	f4odYCAZ-JrzLrgK4gGEaA	120         	0  	1793520534685     	1793520534685        	Observer
data plane: доставлено 5 из 5, ошибки []
control plane: create_topics probe-1793520535 -> OK
Что показал прогон. Первое — проба управления и сразу после остановки, и через 30 секунд закончилась ошибкой _TIMED_OUT. Создание топика не завершилось. Это согласуется с невозможностью зафиксировать метаданные без большинства, но прогон причину таймаута не доказывает, он фиксирует только результат.
Второе — проба данных доставила 5 из 5 сообщений в обоих случаях. Запись в существующий топик продолжала работать для этой версии, одного брокера, одной партиции и фактора репликации 1. Сценарии со сменой ISR прогон не проверял, так что обобщать результат нельзя.
Третье — команда describe —status не получила ответа ни от одного контроллера, включая controller1, поэтому состояние HWM после остановки мы не наблюдали. Прогон также не показал, как controller1 вёл себя без большинства, был ли он лидером, кандидатом или просто не отвечал на запрос. Скрипт quorum.sh перебирает контроллеры по очереди с таймаутом 25 секунд на каждый, а итоговое сообщение фиксирует лишь то, что ответа не было. Что именно произошло с каждым контроллером и сколько времени ушло на ожидание, вывод не показывает. Два остановленных контроллера не могут ответить по определению, а причину молчания controller1 вывод не объясняет, и мы не делаем предположений сверх этого. Поэтому всё сказанное выше о кворуме без большинства относится к протоколу, а наш прогон доказывает только два факта. Создание топика завершилось таймаутом, а запись в уже существующий топик продолжала проходить. Замирание HWM остаётся выводом из протокола, а не измерением.
Четвёртое — строки о voters из метаданных. Это хронология записей VotersRecord, а не текущий список голосующих. Вывод собран из нескольких файлов без их имён, поэтому мы не утверждаем, какая строка из какого файла, а оффсеты разных файлов напрямую не сопоставляем. Первая строка (offset 2) содержит одного voter 1 с адресом localhost. Следующие строки содержат одного voter 1 с адресом контейнера, затем состав из voter 1 и 3 (offset 27) и состав из voter 1, 2 и 3 (offset 29). По оффсетам в выводе запись с voter 3 идёт раньше записи с voter 2, но выводов о причинах порядка мы не делаем. После возврата контроллеров с теми же дисками состав и directory ID остались прежними, а LogEndOffset выровнялся на 120.
Заметим, чего стенд не делает. Он не дописывает VotersRecord офлайн и не форматирует новые диски под старыми именами, потому что поддерживаемого способа сделать это в Apache Kafka нет. Описание Aiven остаётся описанием стороннего инструмента.
Задания
Для всех заданий нужен поднятый стенд из run.sh. Решения лежат в тех же каталогах и используют те же скрипты.
Задание 1. Найти VotersRecord и directory ID каждого voter
Найдите в логе метаданных записи VotersRecord и выпишите идентификаторы реплик и directory ID. Затем сверьте их со списком CurrentVoters из describe —status.
Решение
Скрипт voter_ids.sh вынимает из вывода dump_voters.sh пары идентификаторов регулярным выражением без учёта регистра, а затем печатает блок CurrentVoters. Если шаблон не совпал с форматом декодера, остаётся сырой вывод предыдущего скрипта.
# voter_ids.sh · kafka-dump-log.sh, kafka-metadata-quorum.sh · Kafka 4.3.2
set -uo pipefail
cd "$(dirname "$0")"
echo "== идентификаторы из лога метаданных"
bash dump_voters.sh controller1 | grep -oiE 'voter(Id|DirectoryId)"?[:=] ?"?[A-Za-z0-9_-]+' | sort -u || echo "шаблон ничего не нашёл, смотрите сырой вывод dump_voters.sh"
echo "== CurrentVoters из describe --status"
bash quorum.sh describe --status | grep -A1 CurrentVoters || true
== идентификаторы из лога метаданных
voterDirectoryId":"BSdRjyFXgdLGxMPDT_OfcA
voterDirectoryId":"Hmjhw26jBGwXpbOnKRbUZw
voterDirectoryId":"eqL2BFaoQzKeHB9CPnbXvQ
voterId":1
voterId":2
voterId":3
== CurrentVoters из describe --status
CurrentVoters:          [{"id": 1, "directoryId": "eqL2BFaoQzKeHB9CPnbXvQ", "endpoints": ["CONTROLLER://9d6db4830887:9093"]}, {"id": 2, "directoryId": "BSdRjyFXgdLGxMPDT_OfcA", "endpoints": ["CONTROLLER://7d8817ee1088:9093"]}, {"id": 3, "directoryId": "Hmjhw26jBGwXpbOnKRbUZw", "endpoints": ["CONTROLLER://468c8b6e7110:9093"]}]
CurrentObservers:       [{"id": 4, "directoryId": "f4odYCAZ-JrzLrgK4gGEaA"}]
Задание 2. Остановить один контроллер и сравнить LogEndOffset
Остановите один контроллер из трёх, убедитесь, что пробы проходят, затем верните его и сравните LogEndOffset по describe —replication до и после.
Решение
Проба управления в середине сценария создаёт новый топик, то есть добавляет записи в лог метаданных. Остановленный контроллер эти записи пропускает и после запуска должен их догнать.
# one_down.sh · Docker Compose · confluent-kafka 2.6.1 · Kafka 4.3.2
set -euo pipefail
cd "$(dirname "$0")"
echo "== LogEndOffset до остановки"
bash quorum.sh describe --replication || true
docker compose stop controller3
sleep 5
echo "== проба при двух живых контроллерах"
.venv/bin/python probe.py
echo "== LogEndOffset при остановленном controller3"
bash quorum.sh describe --replication || true
docker compose start controller3
sleep 20
echo "== LogEndOffset после возвращения"
bash quorum.sh describe --replication || true
== LogEndOffset до остановки
NodeId	DirectoryId           	LogEndOffset	Lag	LastFetchTimestamp	LastCaughtUpTimestamp	Status
1     	eqL2BFaoQzKeHB9CPnbXvQ	137         	0  	1793520542207     	1793520542207        	Leader
2     	BSdRjyFXgdLGxMPDT_OfcA	137         	0  	1793520542188     	1793520542188        	Follower
3     	Hmjhw26jBGwXpbOnKRbUZw	137         	0  	1793520542189     	1793520542189        	Follower
4     	f4odYCAZ-JrzLrgK4gGEaA	137         	0  	1793520542187     	1793520542187        	Observer
 Container sat-kafka-15-controller3-1  Stopping
 Container sat-kafka-15-controller3-1  Stopped
== проба при двух живых контроллерах
data plane: доставлено 5 из 5, ошибки []
control plane: create_topics probe-1793520548 -> OK
== LogEndOffset при остановленном controller3
NodeId	DirectoryId           	LogEndOffset	Lag	LastFetchTimestamp	LastCaughtUpTimestamp	Status
1     	eqL2BFaoQzKeHB9CPnbXvQ	156         	0  	1793520550828     	1793520550828        	Leader
2     	BSdRjyFXgdLGxMPDT_OfcA	156         	0  	1793520550696     	1793520550696        	Follower
3     	Hmjhw26jBGwXpbOnKRbUZw	138         	18 	1793520543166     	1793520542698        	Follower
4     	f4odYCAZ-JrzLrgK4gGEaA	156         	0  	1793520550692     	1793520550692        	Observer
 Container sat-kafka-15-controller3-1  Starting
 Container sat-kafka-15-controller3-1  Started
== LogEndOffset после возвращения
NodeId	DirectoryId           	LogEndOffset	Lag	LastFetchTimestamp	LastCaughtUpTimestamp	Status
1     	eqL2BFaoQzKeHB9CPnbXvQ	202         	0  	1793520573651     	1793520573651        	Leader
2     	BSdRjyFXgdLGxMPDT_OfcA	202         	0  	1793520573207     	1793520573207        	Follower
3     	Hmjhw26jBGwXpbOnKRbUZw	202         	0  	1793520573211     	1793520573211        	Follower
4     	f4odYCAZ-JrzLrgK4gGEaA	202         	0  	1793520573207     	1793520573207        	Observer
Задание 3. Скрипт, различающий состояния кластера по двум пробам
Напишите на Python скрипт, который с таймаутом проверяет доступность control plane (create_topics) и data plane (produce) и выдаёт вердикт.
Решение
Две пробы дают четыре комбинации. Запись идёт, а метаданные не меняются — подозрение на потерю кворума. Обе плоскости молчат — проблема скорее в брокере или сети. Деградацию отдельного контроллера по этим признакам не увидеть вовсе, для неё нужен describe —replication, и скрипт честно об этом пишет.
# classify.py · confluent-kafka 2.6.1 · Kafka 4.3.2
from probe import control_plane, data_plane


def classify():
    delivered, errors = data_plane(count=3)
    data_ok = delivered == 3 and not errors
    status, _ = control_plane(timeout=15)
    control_ok = status == "OK"

    if data_ok and control_ok:
        return "норма, обе плоскости отвечают (деградацию одного контроллера эти пробы не видят, смотрите describe --replication)"
    if data_ok and not control_ok:
        return f"подозрение на потерю кворума, запись идёт, а метаданные не меняются (статус {status})"
    if not data_ok and control_ok:
        return f"проблема брокера или партиции, управление отвечает (ошибки {errors})"
    return f"обе плоскости недоступны, проверьте брокер и сеть (статус {status}, ошибки {errors})"


if __name__ == "__main__":
    print(classify())
норма, обе плоскости отвечают (деградацию одного контроллера эти пробы не видят, смотрите describe --replication)
Если вы администрируете кластеры Kafka и хотите разобрать устройство контроллеров, замену узлов и аварийные сценарии на практике, посмотрите курс Администрирование кластера Kafka.
Референсные ссылки
- Исходник. Never lose quorum in Apache Kafka and what to do when you do — запись в блоге Aiven о потере кворума и восстановлении. Содержание KIP-1347 и описание процедуры восстановления в статье даны только по её пересказу, потому что страница предложения при проверке вернула 404.
- KIP-853. KRaft Controller Membership Changes — описание динамического кворума, VotersRecord и команд смены состава.
- Документация. Раздел KRaft документации Apache Kafka — общий справочник по режиму KRaft.