Kafka log segments retention объясняет, почему вы выставили retention.ms в одну минуту, а записи продолжают читаться через час, и диск не освобождается. Это не сбой, а следствие того, что Kafka удаляет файлы-сегменты, а не отдельные сообщения. Ниже мы разбираем механизм хранения (сегменты, индексы, активный сегмент), проверяем его на одном брокере в Docker и смотрим, что показали замеры. Одно из наших ожиданий прогон опроверг, и об этом мы скажем прямо.
Что рассказывает исходник про хранение данных в Kafka
Поводом для статьи стал пост How Kafka Stores Data на Medium. Он отвечает на три вопроса. Почему хранение на диске может быть быстрым. Почему старые записи иногда остаются после срока retention. Как размер сегмента влияет на очистку.
Главная мысль поста в том, что лог партиции нарезан на сегменты, и очистка работает с файлами целиком. Для удаления по времени Kafka смотрит на наибольшую временную метку в сегменте. Автор приводит пример. Сегмент с записями от десяти до одиннадцати утра при суточном сроке хранения остаётся до одиннадцати следующего дня, хотя часть его записей уже старше суток. Отсюда следует, что consumer иногда читает записи старше retention. Это положение исходника, а наши замеры проверяли другой случай, когда все записи старше retention. Мы добавляем то, чего в посте нет, а именно сравнение политик очистки и замеры. Подробности настроек можно найти в документации о логе, настройках топиков и настройках брокера.
Как устроен лог партиции и что такое active segment
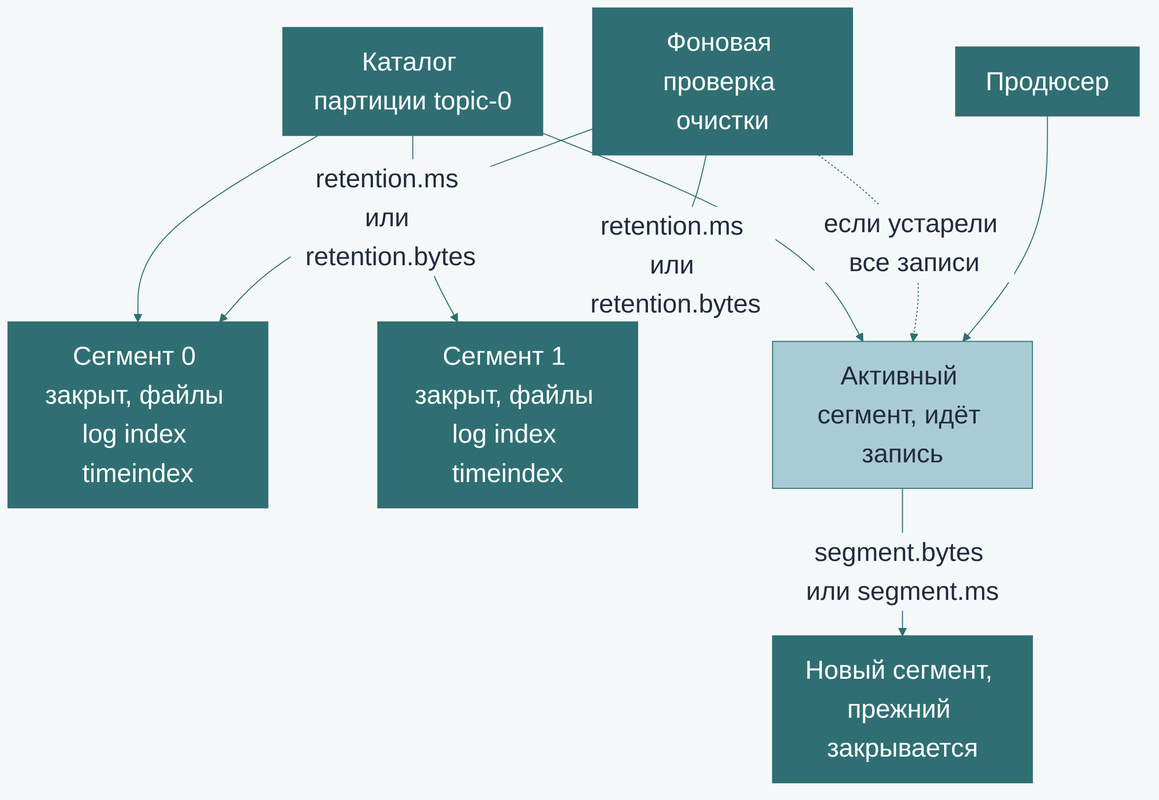
Каждая реплика партиции на брокере это каталог вида имя-топика-номер. Внутри лежит набор сегментов (segment), и каждый сегмент состоит из нескольких файлов с одним и тем же именем. Имя это базовое смещение (base offset) первой записи сегмента, дополненное нулями до двадцати цифр. Число записей в сегменте не фиксировано.
- Файл записей. Расширение log. Сами записи в виде пакетов (record batch), которые дописываются в конец.
- Индекс смещений. Расширение index. Разреженный индекс от смещения к позиции в файле записей. Записи для каждого сообщения в нём нет, Kafka находит ближайшую отметку и дочитывает пакеты вперёд.
- Индекс времени. Расширение timeindex. Индекс от временной метки к смещению, по нему ищут записи по времени.
Эти индексы помогают навигации по смещению и времени, но искать по полям внутри события с их помощью нельзя, как в индексах базы данных.
Запись всегда идёт в последний сегмент, его называют активным (active segment). Остальные сегменты закрыты для записи, но остаются доступными для чтения. Новый сегмент создаётся, когда активный достиг размера segment.bytes или состарился на segment.ms, причиной может стать и другое внутреннее ограничение, например заполненный индекс. Переход к новому сегменту не создаёт новую партицию и не обнуляет смещения, меняется только файл, в который идёт запись.
Почему запись на диск остаётся быстрой
Хранение на диске не делает Kafka медленным по нескольким причинам. Запись последовательная, брокер дописывает пакеты в конец лога и не прыгает по диску. Записи обрабатываются пакетами, поэтому накладные расходы сети и ввода-вывода делятся на много сообщений. Операционная система держит недавно записанные файлы в страничном кэше (page cache), и consumer, идущий близко к хвосту, часто читает из памяти. Наконец, там, где это позволяет путь передачи данных, Kafka может использовать приёмы zero-copy и меньше копировать данные при отправке файла в сеть. Запись в файл при этом не означает мгновенного сброса на физический носитель, надёжность держится на репликации и настройках подтверждений. Размер сегмента на скорость напрямую не влияет, он влияет на очистку, к которой мы и переходим.
Когда сегмент реально удаляется и какие настройки на это влияют
Удаление в Kafka работает с целыми сегментами. Фоновая задача брокера периодически просматривает сегменты и убирает те, что вышли за пределы retention. Период просмотра задаёт параметр брокера log.retention.check.interval.ms, на уровне топика он не настраивается. Сообщение само по себе удалить нельзя, поэтому срок жизни записи на практике равен сроку жизни её сегмента.
Почему запись живёт дольше retention.ms
По описанию в исходнике и документации, для удаления по времени Kafka оценивает наибольшую временную метку в сегменте. Сегмент становится кандидатом на удаление, только когда устарела его самая свежая запись. Отсюда три источника задержки, которые складываются.
- Размер сегмента. При большом segment.bytes и малом потоке данных сегмент заполняется днями, и всё это время его возраст определяет последняя дописанная запись.
- Возраст самой свежей записи. Запись, попавшая в сегмент последней, продлевает жизнь всем остальным записям этого сегмента.
- Интервал проверки. Даже после истечения срока сегмент дождётся очередного прохода фоновой задачи, а потом ещё отложенного физического удаления файла (параметр брокера log.segment.delete.delay.ms).
Поэтому retention.ms следует читать как нижнюю границу срока хранения, а не как гарантию удаления. Это вывод из описанного механизма, а не из наших замеров. На стенде мы проверили только случай, когда все записи, в том числе в последнем сегменте, уже старше retention. Как ведёт себя активный сегмент, пока в него продолжают писать, и как закрытый сегмент со смешанными по возрасту записями, прогон не показал. Тип временной метки (CreateTime против LogAppendTime) мы не меняли и оставили значения по умолчанию.
Роль segment.ms и retention.bytes
Параметр segment.ms позволяет сегменту закрыться по возрасту, даже если он не заполнен. Для топиков с малым потоком это важно, потому что иначе большой сегмент заполняется очень долго, а записи из него не могут уйти под очистку. Наш стенд этот эффект отдельно не измерял.
Параметр retention.bytes ограничивает размер партиции, причём лимит у каждой партиции свой и не делится между ними. Очистка идёт сегментами и асинхронно, поэтому лимит нельзя считать точным потолком занятого места. В задании 3 превышение лимита оказалось близко к размеру активного сегмента, но это один замер на одном наборе настроек, и обобщать его мы не беремся.
Сравнение политик очистки и настроек
Политика задаётся параметром топика cleanup.policy. Таблица ниже описывает общую семантику трёх вариантов по исходнику и документации. В практике мы измеряем только delete, потому что именно он отвечает на вопрос из заголовка, а compact и compact,delete на стенде не запускались. Сжатие данных (compression) это другое понятие. Оно уменьшает число байт при хранении, а компакция убирает устаревшие записи по ключу.
| Политика | Что удаляется | Чем управляется момент | Типичный сценарий | Типичная ловушка |
|---|---|---|---|---|
| delete | Целые сегменты, вышедшие за срок или размер | retention.ms, retention.bytes, размер и возраст сегмента | Потоки событий, логи, метрики | Большой segment.bytes при постоянном потоке записей держит сегмент открытым и молодым |
| compact | Старые значения по ключу, последнее значение остаётся | Фоновая компакция закрытых сегментов | Состояние, справочники, changelog | Оставшиеся записи сохраняют исходные смещения, поэтому в логе возникают пропуски, а ключ исчезает только после записи со значением null (tombstone) |
| compact,delete | И устаревшие значения по ключу, и сегменты за пределами retention | Оба механизма вместе | Состояние с ограниченной историей | Даже последнее значение ключа пропадает, когда уходит его сегмент |
Разбор простой. Для потока событий выигрывает delete, но только с осознанно выбранным размером сегмента. Чтение записи её не удаляет, retention не зависит от прогресса consumer, поэтому медленный consumer может не успеть к записи, а быстрый оставит её лежать. Для состояния подходит compact, и там вопрос retention почти не стоит. Режим compact,delete нужен, когда вы хотите и дедупликацию по ключу, и верхнюю границу хранения. Два последних вывода опираются на исходник и документацию, а не на наш прогон.
Размер сегмента это компромисс. Мелкие сегменты дают более тонкую очистку, но больше файлов, индексов и работы по их обслуживанию. Крупные сегменты экономят файлы, но старые записи дольше делят файл с новыми. Лучшей по пропускной способности универсальной настройки нет, всё зависит от трафика, числа партиций и диска.
Если вам важно настроить хранение на боевом кластере, а не на стенде, этому посвящён курс Администрирование кластера Kafka.
Практика на стенде с одним брокером
Стенд состоит из одного брокера Kafka 4.3.2 в режиме KRaft. На брокере мы снизили интервал проверки очистки до 5 секунд и задержку физического удаления до 1 секунды, иначе ждать пришлось бы минутами. Клиентский код работает на хосте в виртуальном окружении, а каталог партиции мы смотрим через docker exec. Сначала сам стенд.
# compose.yaml · apache/kafka 4.3.2 · KRaft, один узел
services:
  kafka:
    image: apache/kafka:4.3.2
    container_name: kafka
    mem_limit: 2g
    ports:
      - "127.0.0.1:9092:9092"
    environment:
      KAFKA_NODE_ID: 1
      KAFKA_PROCESS_ROLES: broker,controller
      KAFKA_LISTENERS: PLAINTEXT://:9092,CONTROLLER://:9093
      KAFKA_ADVERTISED_LISTENERS: PLAINTEXT://localhost:9092
      KAFKA_CONTROLLER_LISTENER_NAMES: CONTROLLER
      KAFKA_LISTENER_SECURITY_PROTOCOL_MAP: CONTROLLER:PLAINTEXT,PLAINTEXT:PLAINTEXT
      KAFKA_CONTROLLER_QUORUM_VOTERS: 1@localhost:9093
      KAFKA_OFFSETS_TOPIC_REPLICATION_FACTOR: 1
      KAFKA_TRANSACTION_STATE_LOG_REPLICATION_FACTOR: 1
      KAFKA_TRANSACTION_STATE_LOG_MIN_ISR: 1
      KAFKA_GROUP_INITIAL_REBALANCE_DELAY_MS: 0
      KAFKA_LOG_DIRS: /tmp/kafka-logs
      KAFKA_LOG_RETENTION_CHECK_INTERVAL_MS: 5000
      KAFKA_LOG_SEGMENT_DELETE_DELAY_MS: 1000
      KAFKA_HEAP_OPTS: "-Xmx512m -Xms512m"
Зависимость у нас одна, это клиент confluent-kafka. Все примеры выполнены именно на версии 2.6.1, поэтому мы её и закрепили. Код использует только базовые вызовы Producer, Consumer и AdminClient, и на более новых версиях клиента мы его не запускали.
# requirements.txt
confluent-kafka==2.6.1
Общие функции вынесены в модуль common.py. Он ждёт готовности брокера, создаёт топик с заданными настройками, пишет записи по 1000 байт, читает границы смещений и показывает файлы каталога партиции. Для размеров файлов используется обычный ls -l внутри контейнера.
# common.py · confluent-kafka 2.6.1 · Kafka 4.3.2
import subprocess
import time

from confluent_kafka import Consumer, Producer, TopicPartition
from confluent_kafka.admin import AdminClient, NewTopic

BOOTSTRAP = "127.0.0.1:9092"
LOG_DIR = "/tmp/kafka-logs"


def get_admin():
    admin = AdminClient({"bootstrap.servers": BOOTSTRAP})
    for _ in range(30):
        try:
            admin.list_topics(timeout=5)
            return admin
        except Exception:
            time.sleep(2)
    raise RuntimeError("брокер не поднялся")


def create_topic(name, config):
    admin = get_admin()
    if name in admin.list_topics(timeout=10).topics:
        for future in admin.delete_topics([name]).values():
            future.result()
        for _ in range(30):
            if name not in admin.list_topics(timeout=10).topics:
                break
            time.sleep(1)
        time.sleep(2)
    for _ in range(15):
        futures = admin.create_topics([NewTopic(name, 1, 1, config=config)])
        try:
            for future in futures.values():
                future.result()
            break
        except Exception as e:
            if "ALREADY_EXISTS" not in str(e):
                raise
            time.sleep(2)
    time.sleep(2)


def produce(topic, count, size=1000):
    producer = Producer({"bootstrap.servers": BOOTSTRAP, "linger.ms": 5})
    payload = b"x" * size
    for _ in range(count):
        while True:
            try:
                producer.produce(topic, value=payload)
                break
            except BufferError:
                producer.poll(0.1)
        producer.poll(0)
    producer.flush()


def low_high(topic):
    consumer = Consumer({"bootstrap.servers": BOOTSTRAP, "group.id": "probe"})
    low, high = consumer.get_watermark_offsets(
        TopicPartition(topic, 0), timeout=10, cached=False
    )
    consumer.close()
    return low, high


def list_files(topic):
    out = subprocess.run(
        ["docker", "exec", "kafka", "ls", "-l", f"{LOG_DIR}/{topic}-0"],
        check=True, capture_output=True, text=True,
    ).stdout
    files = []
    for line in out.splitlines():
        parts = line.split()
        if len(parts) < 9 or not parts[0].startswith("-"):
            continue
        files.append((parts[-1], int(parts[4])))
    return sorted(files)


def log_files(topic):
    return [(n, s) for n, s in list_files(topic) if n.endswith(".log")]


def dump_log(topic, filename):
    return subprocess.run(
        ["docker", "exec", "-e", "KAFKA_HEAP_OPTS=-Xmx128m", "kafka",
         "/opt/kafka/bin/kafka-dump-log.sh",
         "--files", f"{LOG_DIR}/{topic}-0/{filename}"],
        check=True, capture_output=True, text=True,
    ).stdout
Основной пример создаёт топик с сегментом 1 МБ и retention.ms в 30 секунд, пишет 4000 записей по 1000 байт (около 4 МБ с накладными расходами на заголовки пакетов) и раз в 10 секунд печатает границы смещений и число сегментов. Нас интересуют две вещи. Что станет с последним сегментом, у которого тоже все записи старше 30 секунд, и как сдвигается log start offset (в клиентском API это low watermark).
# segments_demo.py · confluent-kafka 2.6.1 · Kafka 4.3.2
import time

from common import create_topic, produce, low_high, list_files, log_files

TOPIC = "seg-demo"

create_topic(TOPIC, {"segment.bytes": "1048576", "retention.ms": "30000"})
produce(TOPIC, 4000)

print("Файлы сразу после записи")
for name, size in list_files(TOPIC):
    print(f"  {name} {size}")

start = time.time()
while True:
    elapsed = int(time.time() - start)
    low, high = low_high(TOPIC)
    logs = log_files(TOPIC)
    print(f"t={elapsed:3d}s low={low} high={high} сегментов .log={len(logs)}")
    if len(logs) == 1 or elapsed >= 120:
        break
    time.sleep(10)

print("Файлы в конце")
for name, size in list_files(TOPIC):
    print(f"  {name} {size}")

low, high = low_high(TOPIC)
print(f"Записей, которые ещё можно прочитать: {high - low}")
Файлы сразу после записи
  00000000000000000000.index 0
  00000000000000000000.log 999897
  00000000000000000000.timeindex 12
  00000000000000000990.index 0
  00000000000000000990.log 999897
  00000000000000000990.snapshot 10
  00000000000000000990.timeindex 12
  00000000000000001980.index 0
  00000000000000001980.log 999897
  00000000000000001980.snapshot 10
  00000000000000001980.timeindex 12
  00000000000000002970.index 10485760
  00000000000000002970.log 1040318
  00000000000000002970.snapshot 10
  00000000000000002970.timeindex 10485756
  leader-epoch-checkpoint 8
  partition.metadata 43
t=  0s low=0 high=4000 сегментов .log=4
t= 10s low=0 high=4000 сегментов .log=4
t= 20s low=0 high=4000 сегментов .log=4
t= 30s low=0 high=4000 сегментов .log=4
t= 40s low=4000 high=4000 сегментов .log=1
Файлы в конце
  00000000000000004000.log 0
  00000000000000004000.snapshot 10
  00000000000000004000.timeindex 10485756
  leader-epoch-checkpoint 11
  partition.metadata 43
Записей, которые ещё можно прочитать: 0
Запуск стенда и примера собран в run.sh. Он не гасит стенд, это делает внешний раннер.
#!/usr/bin/env bash
# run.sh · docker compose · Python 3 · Kafka 4.3.2
set -euo pipefail
cd "$(dirname "$0")"
docker compose up -d
python3 -m venv .venv
.venv/bin/pip install -q -r requirements.txt
.venv/bin/python segments_demo.py
Что показал прогон. Сразу после записи в каталоге лежат четыре файла записей с базовыми смещениями 0, 990, 1980 и 2970. У первых трёх размер одинаковый, 999897 байт, а у последнего 1040318 байт, и только у него индекс предвыделен на 10485760 байт, так что это активный сегмент, в который шла запись. До 30-й секунды всё на месте, а на 40-й секунде low равен high и равен 4000, то есть не читается ни одной записи. В каталоге остался единственный файл записей с базовым смещением 4000 и нулевым размером. Итог такой. Закрытые сегменты 0, 990 и 1980 исчезли, вместе с ними исчезли и записи активного сегмента 2970, а остался только пустой сегмент 4000. Как именно это произошло, прогон не показал.
Наше ожидание о том, что последний сегмент переживёт очистку вместе со своими записями, не подтвердилось. Почему так вышло, прогон не показывает. Гипотеза в том, что при устаревании всех сегментов брокер сначала закрывает текущий и создаёт новый пустой, чтобы у партиции не оставалось ноль сегментов, но мы её не проверяли, например по журналу брокера. Достоверно видно одно. Когда все записи активного сегмента старше retention, на этом стенде он был заменён пустым вместе с остальными. Как ведёт себя активный сегмент, пока в него продолжают писать, прогон не проверял, и общим правилом это наблюдение считать нельзя. Замер один, на одном брокере, с одним набором настроек.
Задания
Все решения используют тот же common.py и запускаются на том же стенде. Каждое печатает данные, по которым вывод делается из цифр, а не из описания.
Задание 1. Большой сегмент против малого
Сравните три топика с одинаковым retention.ms. В первом сегмент огромный, во втором маленький, в третьем сегмент большой, но segment.ms короткий. Посмотрите, что останется в каждом после ожидания.
Решение
Создаём три топика с retention.ms в 20 секунд. Пишем по 600 записей в big-seg и ms-seg и 3000 записей в small-seg, чтобы набралось несколько мегабайтных сегментов. Ждём 15 секунд, дописываем в каждый топик по одной записи и ждём ещё минуту.
# task1.py · confluent-kafka 2.6.1 · Kafka 4.3.2
import time

from common import create_topic, produce, low_high, log_files

RETENTION = "20000"
TOPICS = {
    "big-seg": {"segment.bytes": str(1024 ** 3), "retention.ms": RETENTION},
    "small-seg": {"segment.bytes": "1048576", "retention.ms": RETENTION},
    "ms-seg": {"segment.bytes": str(1024 ** 3), "segment.ms": "10000",
               "retention.ms": RETENTION},
}
COUNTS = {"big-seg": 600, "small-seg": 3000, "ms-seg": 600}

for name, config in TOPICS.items():
    create_topic(name, config)
    produce(name, COUNTS[name])

time.sleep(15)
for name in TOPICS:
    produce(name, 1)

time.sleep(60)
for name in TOPICS:
    low, high = low_high(name)
    logs = log_files(name)
    print(f"{name:10s} low={low:4d} high={high:4d} сегментов .log={len(logs)}")
big-seg    low= 601 high= 601 сегментов .log=1
small-seg  low=3001 high=3001 сегментов .log=1
ms-seg     low= 601 high= 601 сегментов .log=1
Во всех трёх топиках low равен high, то есть удалены все записи вместе с дописанной одиночной (601 и 3001 это число записей плюс одна), в том числе из единственного сегмента big-seg. Вероятное объяснение в расчёте времени. Последняя запись пришла на 15-й секунде, а проверка шла через минуту, и к этому моменту даже самая свежая запись была старше 20 секунд. Вывод согласуется с этой гипотезой и с основным примером, но не доказывает её, потому что состояние между записью и проверкой мы не снимали. Такой опыт не различает большой сегмент и segment.ms, ведь все три топика оказались в одинаковом положении, и на вопрос о том, дольше ли живёт запись в большом сегменте, он ответа не даёт.
Чтобы увидеть разницу, опыт нужно изменить. Например, писать в big-seg по одной записи каждые 10 секунд, чтобы самая свежая запись в активном сегменте всё время оставалась моложе 20 секунд. Мы ожидаем, что старые записи в таком топике останутся, а в small-seg закрытые сегменты уйдут, но это предположение мы не запускали.
Задание 2. Предсказать момент удаления сегмента
Прочитайте закрытый сегмент через kafka-dump-log.sh, найдите максимальную временную метку и предскажите момент удаления. Затем проверьте предсказание по списку файлов.
Решение
Берём первый закрытый сегмент, вытаскиваем из вывода дампа значения CreateTime и считаем момент удаления как максимум плюс retention. Затем раз в секунду смотрим, пропал ли файл записей этого сегмента.
# task2.py · confluent-kafka 2.6.1 · Kafka 4.3.2
import re
import time

from common import create_topic, produce, list_files, dump_log

TOPIC = "ts-demo"
RETENTION_S = 45

create_topic(TOPIC, {"segment.bytes": "1048576",
                     "retention.ms": str(RETENTION_S * 1000)})
produce(TOPIC, 1500)

logs = [n for n, _ in list_files(TOPIC) if n.endswith(".log")]
closed = logs[0]
text = dump_log(TOPIC, closed)
stamps = [int(x) for x in re.findall(r"CreateTime: (\d+)", text)]
max_ts = max(stamps) / 1000
predicted = max_ts + RETENTION_S

print(f"Сегмент {closed}, пакетов с CreateTime: {len(stamps)}")
print(f"Прогноз удаления через {predicted - time.time():.1f} с от момента дампа")

deadline = predicted + 60
while time.time() < deadline:
    names = [n for n, _ in list_files(TOPIC)]
    if closed not in names:
        break
    time.sleep(1)

actual = time.time()
print(f"Файл .log исчез через {actual - max_ts:.1f} с после последней записи сегмента")
print(f"Расхождение с прогнозом {actual - predicted:.1f} с")
Сегмент 00000000000000000000.log, пакетов с CreateTime: 1
Прогноз удаления через 43.0 с от момента дампа
Файл .log исчез через 49.6 с после последней записи сегмента
Расхождение с прогнозом 4.6 с
Этот замер ненадёжен, и подтверждением модели его считать нельзя. Скрипт нашёл всего одно значение CreateTime, а для сегмента в 999897 байт, то есть около 990 записей, это выглядит слишком мало. Мы не выясняли, почему так вышло, поэтому неизвестно, действительно ли найденное значение является максимумом временной метки сегмента, и причину расхождения в 4,6 секунды по этим данным назвать нельзя. Чтобы проверить модель по-настоящему, посмотрите вывод kafka-dump-log.sh целиком, убедитесь, что собраны временные метки всех пакетов, и повторите опыт на нескольких сегментах.
Задание 3. Лимит retention.bytes и активный сегмент
Включите retention.bytes и посмотрите, как итоговый размер партиции соотносится с лимитом и размером активного сегмента.
Решение
Задаём лимит 2 000 000 байт при сегменте в 1 МБ, а retention.ms ставим в сутки, чтобы время не мешало. Пишем около 5 МБ и каждые 5 секунд печатаем суммарный размер сегментов, размер активного и размер закрытых.
# task3.py · confluent-kafka 2.6.1 · Kafka 4.3.2
import time

from common import create_topic, produce, low_high, log_files

TOPIC = "bytes-demo"
LIMIT = 2_000_000

create_topic(TOPIC, {"segment.bytes": "1048576",
                     "retention.bytes": str(LIMIT),
                     "retention.ms": "86400000"})
produce(TOPIC, 5000)

for step in range(8):
    logs = log_files(TOPIC)
    total = sum(size for _, size in logs)
    active = logs[-1][1]
    low, high = low_high(TOPIC)
    print(f"t={step * 5:2d}s low={low} high={high} сегментов={len(logs)} "
          f"всего={total} активный={active} закрытые={total - active} лимит={LIMIT}")
    time.sleep(5)
t= 0s low=0 high=5000 сегментов=6 всего=5049996 активный=50511 закрытые=4999485 лимит=2000000
t= 5s low=2970 high=5000 сегментов=3 всего=2050305 активный=50511 закрытые=1999794 лимит=2000000
t=10s low=2970 high=5000 сегментов=3 всего=2050305 активный=50511 закрытые=1999794 лимит=2000000
t=15s low=2970 high=5000 сегментов=3 всего=2050305 активный=50511 закрытые=1999794 лимит=2000000
t=20s low=2970 high=5000 сегментов=3 всего=2050305 активный=50511 закрытые=1999794 лимит=2000000
t=25s low=2970 high=5000 сегментов=3 всего=2050305 активный=50511 закрытые=1999794 лимит=2000000
t=30s low=2970 high=5000 сегментов=3 всего=2050305 активный=50511 закрытые=1999794 лимит=2000000
t=35s low=2970 high=5000 сегментов=3 всего=2050305 активный=50511 закрытые=1999794 лимит=2000000
Столбец «всего» держится на 2050305 при лимите 2000000, то есть превышение составляет 50305 байт. Это близко к размеру активного сегмента в 50511 байт, но точного равенства нет. Закрытые сегменты занимают 1999794 байта и в лимит укладываются. Картина согласуется с тем, что лимит считается по закрытым сегментам, а активный сегмент сверху, однако доказательством это не служит. Замер один, на фиксированных данных и одном размере сегмента, и для других настроек мы так утверждать не будем.
Если вы хотите системно разобраться с хранением, репликацией и настройкой кластера, посмотрите курс Администрирование кластера Kafka, где эти вопросы разбираются на практике.