Kafka log compaction обещает хранить последнее значение по каждому ключу, но обещает меньше, чем кажется. Инженер, который строит на compacted-топике состояние сервиса, рано или поздно спрашивает, почему дубликаты всё ещё читаются, куда пропали offset и сколько памяти нужно cleaner’у. В этой статье мы разбираем алгоритм по материалу инженеров WarpStream, затем собираем стенд на одном KRaft-брокере и смотрим на результат своими глазами.
Что разбирает исходник
В блоге WarpStream (компания, которая делает Kafka-совместимую платформу поверх объектного хранилища) вышла статья Kafka as a KV Store. Авторы объясняют, как устроены compacted-топики, и показывают, почему их нельзя реализовать с идеальной дедупликацией при ограниченной памяти.
Главное из исходника своими словами. Обычный топик удаляет данные по размеру или возрасту, а compacted-топик (compacted topic, политика cleanup.policy=compact) оставляет запись, пока она является последней версией своего ключа в партиции. Поэтому объём диска и время рестарта консьюмера зависят от числа уникальных ключей, а не от числа операций за всю историю. Так устроены хранилище смещений групп потребителей, Kafka Connect, Schema Registry и changelog-топики в Kafka Streams.
Дальше авторы идут от наивной однопроходной реализации, которой нужно держать в памяти последнюю запись каждого ключа целиком, к схеме Kafka. Kafka читает сегмент дважды. Сначала строится карта из хеша ключа и последнего offset, потом по ней отбираются записи для нового сегмента. В карте хранится 16-байтовый хеш MD5 (Message-Digest Algorithm 5) и 8-байтовый offset. Из этого авторы делают вывод, что 128 MB буфера хватает больше чем на 5 млн ключей в одной партиции, как бы велики ни были ключи и значения.
Вторая половина статьи про то, как WarpStream повторяет этот алгоритм на объектном хранилище с двумя потоками чтения на файл. Это их реализация, на стенде мы её не проверяем, и в разбор она не входит. Любопытно только одно утверждение авторов, которое мы приводим как их мнение. Они считают, что многие реализации tiered storage вообще не поддерживают compacted-топики, потому что архитектура Kafka рассчитана на дешёвый seek в локальном файле.
Как устроен log cleaner под капотом
Исходник объясняет алгоритм, но почти не говорит о том, что видит администратор. Ниже мы добавляем к нему эксплуатационную сторону.
Два прохода и offset map
Очисткой занимаются потоки log cleaner. Каждый поток выбирает лог с наибольшей долей грязной части (dirty ratio), строит для неё карту offset map и переписывает сегменты. Карта живёт в буфере дедупликации (dedupe buffer), размер которого задаёт параметр брокера log.cleaner.dedupe.buffer.size. Параметр log.cleaner.io.buffer.load.factor регулирует, насколько заполненным может быть этот буфер. Расчёты ниже опираются на значение 0,9, которое мы принимаем за типичное. Чем плотнее заполнена хеш-таблица карты, тем больше в ней коллизий при вставке, но это внутреннее свойство таблицы, а не коллизии самих MD5-хешей.

Схема иллюстративная и не является снимком стенда. По замыслу алгоритма записи после компакции не получают новые offset. Если ключ K1 жил на offset 0, 2 и 3, останется запись с offset 3, а offset 0 и 2 превращаются в дыры. Консьюмеры к этому готовы, об этом пишут и авторы исходника. Наш прогон ниже дыр между записями не показал, и что это значит, мы обсуждаем после вывода.
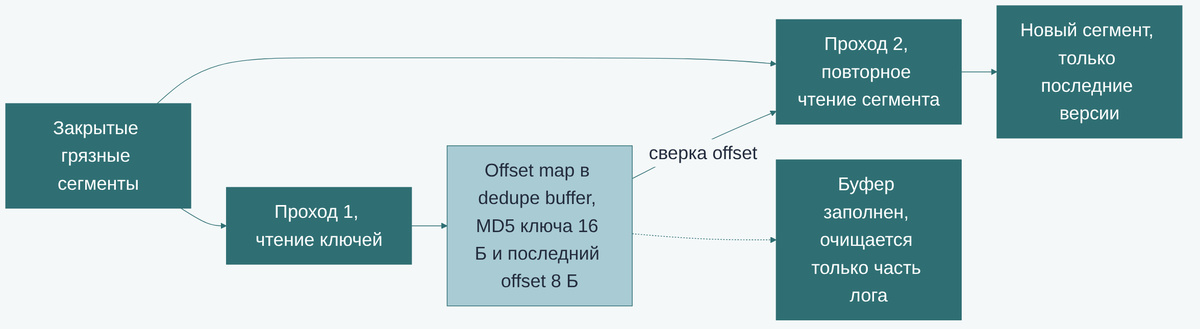
Первый проход читает грязную часть лога и для каждого ключа запоминает последний offset. Второй проход читает сегмент заново и копирует в новый файл только те записи, чей offset совпадает с запомненным. Цена такой схемы в том, что каждая запись десериализуется дважды, зато в памяти не лежат значения.
Арифметика dedupe buffer
Одна запись offset map занимает 24 байта, то есть 16 байт хеша и 8 байт offset. Если бы в карте лежал сам ключ вроде 36-символьного UUID, запись заняла бы 44 байта, а ёмкость упала бы почти вдвое. Отсюда и выбор в пользу хеша. Kafka считает два ключа равными, если равны их хеши, и принимает риск коллизии как пренебрежимо малый.
Посчитаем для буфера 128 MiB. Без учёта load factor получается 128 MiB / 24 байта, примерно 5,59 млн ключей. С load factor 0,9 остаётся около 5,03 млн. Поэтому «примерно 5,5 млн», которые встречаются в разговорах, верны только для полностью заполненного буфера. В задании 1 ниже мы проверяем эти числа скриптом.
Ключевое слово здесь «в одной партиции за один проход». Карта ограничена по размеру, поэтому по замыслу, описанному в исходнике, при очень большом числе уникальных ключей полной дедупликации за один проход ждать нельзя. Отсюда вывод авторов исходника, что полной гарантии удаления старых версий нет, и размер буфера стоит соотносить с числом уникальных ключей в партиции.
Когда compaction срабатывает и когда нет
На практике дубликаты читаются дольше, чем ожидают, и у этого есть несколько причин. Перечислим те, которые надо знать эксплуатации.
- Активный сегмент не компактируется. Cleaner работает только с закрытыми сегментами. Пока запись лежит в активном сегменте, все её дубликаты читаются. Закрыть сегмент можно по размеру (segment.bytes) или по возрасту (segment.ms). В задании 2 мы использовали дополнительную запись ping, чтобы ролл сегмента произошёл надёжно, а нужна ли она обязательно, прогон не доказывает.
- Dirty ratio. Лог попадает в очередь на очистку, когда доля неочищенной части превышает min.cleanable.dirty.ratio. На продуктивных значениях по умолчанию это защищает диск от лишней перезаписи, на стенде мы опускаем порог до 0,01.
- Задержка компакции. Параметр min.compaction.lag.ms задаёт, сколько запись обязана прожить без очистки. Если консьюмеры должны успевать видеть промежуточные версии, значение нужно увеличивать.
- Интервал опроса cleaner. Параметр брокера log.cleaner.backoff.ms определяет, как часто cleaner просыпается, если работы нет. Мы уменьшаем его на стенде, иначе ожидание результата растягивается.
- Tombstone. Запись с ключом и значением null (tombstone, «надгробие») означает удаление ключа. Сама она хранится ещё delete.retention.ms, чтобы консьюмеры успели её увидеть, и только потом удаляется очередным проходом cleaner.
Консьюмер, который отстал от лога дольше delete.retention.ms, может пропустить tombstone и навсегда оставить удалённый ключ в своём локальном состоянии. Этот риск мы разбираем в задании 3. Следить за cleaner удобно по метрикам JMX (Java Management Extensions) в группе LogCleaner, среди которых есть заполнение буфера дедупликации.
Compacted-топик и альтернативы
Прежде чем строить состояние на compaction, стоит сравнить его с соседними политиками и с внешним хранилищем. Критерии в таблице взяты из исходника и из того, что мы проверяем на стенде. Строка про внешнее хранилище описывает общие свойства KV (key-value, «ключ-значение») хранилищ вроде Redis или RocksDB, а не измерения этой статьи.
| Критерий | compact | delete с бесконечным retention | compact,delete | Внешнее KV-хранилище |
|---|---|---|---|---|
| Что определяет объём | Число уникальных ключей | Число всех операций за историю | Число уникальных ключей, ограниченное временем хранения | Число уникальных ключей |
| Рестарт консьюмера | Чтение O(n) по числу ключей | Чтение O(n) по числу операций | Как у compact, но старые версии пропадают по времени | Лог можно не перечитывать, состояние берётся из хранилища |
| Гарантия дедупликации | Нет, зависит от памяти cleaner’а и сегментов | Не нужна, история полная | Нет, как у compact | Есть, ключ перезаписывается на месте |
| Удаление ключа | Tombstone и delete. |
Только по retention | Tombstone и удаление старых сегментов по времени | Прямая команда удаления |
| Типичные сценарии | Смещения групп, Connect offsets, changelog Kafka Streams | Журнал событий | Состояние с ограниченным сроком жизни | Состояние с точными чтениями по ключу |
Compact выигрывает там, где состояние должно переживать рестарты читателей и жить в самой Kafka, а точная дедупликация не требуется, потому что консьюмер всё равно применяет записи по порядку. Обычный delete проще, но при бесконечном retention время старта растёт вместе с историей, о чём пишут и авторы исходника. Вариант compact,delete подходит, когда нужны оба ограничения сразу, например состояние сессий, которое устаревает по времени. Внешнее KV-хранилище нужно, если читателям требуются точные чтения по ключу без перечитывания лога, но это ещё одна система, и согласованность с логом вы поддерживаете сами. Если вы строите состояние на Kafka Streams, changelog-топики с политикой compact уже включены в архитектуру, и для этого случая подойдёт курс по Kafka Streams для разработчиков.
Практика запуск compaction на KRaft-брокере
Стенд состоит из одного брокера Kafka 4.3.2 в режиме KRaft (Kafka Raft) и Python-скриптов на хосте. Параметры подобраны агрессивно. Сегмент ограничен 1 MiB, порог dirty ratio равен 0,01, интервал опроса cleaner равен секунде, а delete.retention.ms измеряется секундами. Так результат появляется за минуты, но на продуктивном кластере такие значения создавали бы лишнюю нагрузку на диск.
Сначала описание сервисов. Здесь же задаётся размер dedupe buffer, равный значению по умолчанию, чтобы он был виден в конфигурации.
# compose.yaml · apache/kafka 4.3.2
services:
  kafka:
    image: apache/kafka:4.3.2
    mem_limit: 1g
    ports:
      - "127.0.0.1:9092:9092"
    environment:
      KAFKA_NODE_ID: 1
      KAFKA_PROCESS_ROLES: broker,controller
      KAFKA_LISTENERS: PLAINTEXT://:9092,CONTROLLER://:9093
      KAFKA_ADVERTISED_LISTENERS: PLAINTEXT://127.0.0.1:9092
      KAFKA_CONTROLLER_LISTENER_NAMES: CONTROLLER
      KAFKA_LISTENER_SECURITY_PROTOCOL_MAP: CONTROLLER:PLAINTEXT,PLAINTEXT:PLAINTEXT
      KAFKA_CONTROLLER_QUORUM_VOTERS: 1@localhost:9093
      KAFKA_OFFSETS_TOPIC_REPLICATION_FACTOR: 1
      KAFKA_TRANSACTION_STATE_LOG_REPLICATION_FACTOR: 1
      KAFKA_TRANSACTION_STATE_LOG_MIN_ISR: 1
      KAFKA_LOG_DIRS: /tmp/kraft-combined-logs
      KAFKA_LOG_CLEANER_BACKOFF_MS: 1000
      KAFKA_LOG_CLEANER_DEDUPE_BUFFER_SIZE: 134217728
      KAFKA_HEAP_OPTS: "-Xms512m -Xmx512m"
    healthcheck:
      test: ["CMD-SHELL", "/opt/kafka/bin/kafka-broker-api-versions.sh --bootstrap-server localhost:9092 > /dev/null 2>&1"]
      interval: 5s
      timeout: 10s
      retries: 20
Зависимость одна, клиент confluent-kafka. Версия закреплена ради воспроизводимости стенда, а используемые вызовы (Producer, Consumer, AdminClient) входят в базовый API клиента и работают с брокером 4.3.2.
# requirements.txt
confluent-kafka==2.6.1
Скрипт run.sh поднимает брокер, создаёт окружение и запускает основной пример. Остановкой стенда и запуском заданий он не занимается.
#!/usr/bin/env bash
# run.sh · Docker Compose · Kafka 4.3.2
set -euo pipefail
cd "$(dirname "$0")"
docker compose up -d --wait
python3 -m venv .venv
.venv/bin/pip install -q -r requirements.txt
.venv/bin/python compact_demo.py
Общие функции вынесены в kafka_util.py. Это создание топика, запись, полное чтение партиции с начала и ожидание компакции. Ожидание построено на эвристике. Мы считаем, что cleaner закончил, когда число записей стало меньше исходного и не меняется три замера подряд. Для стенда этого достаточно, для продуктивной диагностики лучше использовать метрики cleaner.
# kafka_util.py · confluent-kafka 2.6.1 · Kafka 4.3.2
import time

from confluent_kafka import KafkaError, KafkaException, OFFSET_BEGINNING, Consumer, Producer, TopicPartition
from confluent_kafka.admin import AdminClient, NewTopic

BOOT = "127.0.0.1:9092"


def create_topic(name, configs):
    admin = AdminClient({"bootstrap.servers": BOOT})
    deleted = False
    deadline = time.time() + 60
    while True:
        futures = admin.create_topics(
            [NewTopic(name, num_partitions=1, replication_factor=1, config=configs)]
        )
        try:
            futures[name].result(timeout=30)
            return
        except KafkaException as e:
            if e.args[0].code() != KafkaError.TOPIC_ALREADY_EXISTS or time.time() > deadline:
                raise
        if not deleted:
            try:
                admin.delete_topics([name])[name].result(timeout=30)
            except KafkaException as e:
                if e.args[0].code() != KafkaError.UNKNOWN_TOPIC_OR_PART:
                    raise
            deleted = True
        time.sleep(1)


def produce(topic, records):
    producer = Producer({"bootstrap.servers": BOOT})
    for key, value in records:
        producer.produce(topic, key=key, value=value)
        producer.poll(0)
    producer.flush(30)


def read_all(topic, timeout=30):
    consumer = Consumer({
        "bootstrap.servers": BOOT,
        "group.id": "reader-%d" % time.time_ns(),
        "enable.auto.commit": False,
        "auto.offset.reset": "earliest",
    })
    low, high = consumer.get_watermark_offsets(TopicPartition(topic, 0), timeout=10)
    rows = []
    if high <= low:
        consumer.close()
        return rows
    consumer.assign([TopicPartition(topic, 0, OFFSET_BEGINNING)])
    deadline = time.time() + timeout
    while time.time() < deadline:
        msg = consumer.poll(1.0)
        if msg is None or msg.error():
            continue
        value = None if msg.value() is None else msg.value().decode()
        rows.append((msg.offset(), msg.key().decode(), value))
        if msg.offset() >= high - 1:
            break
    consumer.close()
    return rows


def wait_compaction(topic, initial, timeout=120):
    previous = None
    stable = 0
    deadline = time.time() + timeout
    count = initial
    while time.time() < deadline:
        count = len(read_all(topic))
        stable = stable + 1 if count == previous else 0
        if count < initial and stable >= 2:
            return count
        previous = count
        time.sleep(3)
    return count
Основной пример пишет 6000 записей по значению около 1 КБ, то есть 50 ключей по 120 раундов, и ждёт работы cleaner. Затем он печатает число записей, число уникальных ключей и суммарное число дыр в offset между соседними прочитанными записями. В конце проверяется, что для каждого ключа сохранилась запись последнего раунда.
# compact_demo.py · confluent-kafka 2.6.1 · Kafka 4.3.2
from kafka_util import create_topic, produce, read_all, wait_compaction

TOPIC = "demo-compact"
KEYS = 50
ROUNDS = 120

create_topic(TOPIC, {
    "cleanup.policy": "compact",
    "segment.bytes": "1048576",
    "min.cleanable.dirty.ratio": "0.01",
    "min.compaction.lag.ms": "0",
    "delete.retention.ms": "2000",
})

records = [
    ("k%02d" % k, ("r%03d" % r).ljust(1000, "x"))
    for r in range(ROUNDS)
    for k in range(KEYS)
]
produce(TOPIC, records)


def summary(rows):
    keys = {key for _, key, _ in rows}
    gaps = sum(b[0] - a[0] - 1 for a, b in zip(rows, rows[1:]))
    return len(rows), len(keys), gaps


before = read_all(TOPIC)
print("до компакции  записей=%d ключей=%d дыр в offset=%d" % summary(before))

wait_compaction(TOPIC, len(before))
after = read_all(TOPIC)
count, keys, gaps = summary(after)
print("после         записей=%d ключей=%d дыр в offset=%d" % (count, keys, gaps))
print("дубликатов осталось (хвост, активный сегмент)=%d" % (count - keys))

print("первые записи после компакции (offset, ключ, раунд)")
for offset, key, value in after[:8]:
    print("  %5d %s %s" % (offset, key, value[:4]))

latest = {}
for _, key, value in after:
    latest[key] = value[:4]
expected = "r%03d" % (ROUNDS - 1)
print("последний раунд сохранён у всех ключей=%s" % all(v == expected for v in latest.values()))
до компакции  записей=6000 ключей=50 дыр в offset=0
после         записей=910 ключей=50 дыр в offset=0
дубликатов осталось (хвост, активный сегмент)=860
первые записи после компакции (offset, ключ, раунд)
   5090 k40 r101
   5091 k41 r101
   5092 k42 r101
   5093 k43 r101
   5094 k44 r101
   5095 k45 r101
   5096 k46 r101
   5097 k47 r101
последний раунд сохранён у всех ключей=True
Прогон показал главное. Записей стало 910 вместо 6000, ключей по-прежнему 50, а у каждого ключа сохранён последний раунд. Остались 860 дубликатов, и это не противоречит документации, потому что Kafka не гарантирует полную дедупликацию. Где именно эти дубликаты лежат, прогон не показывает. Можно предположить, что это необработанный хвост лога, в том числе активный сегмент, но границы сегментов мы не смотрели, поэтому это гипотеза. Эффект активного сегмента мы проверяем отдельно в задании 2.
Дыр в offset прогон не показал. Счётчик дыр равен 0 и до, и после, а число записей 910 совпадает с диапазоном offset от 5090 до 5999. По этому счётчику выжившие записи идут подряд, хотя в выводе напечатаны только первые восемь. Удалённая голова лога стоит до первой записи и в счёт не попадает. Возможное объяснение в том, что записи пишутся по кругу, каждый ключ обновляется раз в 50 записей, и выжившие версии лежат вплотную к необработанному хвосту, но это предположение, прогон его не проверял. Поэтому утверждение про дыры внутри лога этот прогон не подтверждает и не опровергает. Чтобы увидеть дыры, нужно, чтобы между выжившими записями лежали удалённые, например при ключах, обновляемых с разной частотой. Утилитой kafka-dump-log.sh внутри контейнера можно посмотреть сегменты напрямую, путь к файлам зависит от параметра log.dirs.
Задания
Три задачи проверяют то, что в теории выглядит очевидным, а на стенде оказывается тонким. Прежде чем открывать решение, попробуйте предсказать результат.
Задание 1. Ёмкость dedupe buffer
Рассчитайте, сколько уникальных ключей умещается в log.cleaner.dedupe.buffer.size = 128 MiB при load factor 0,9 и записи 24 байта (16 байт хеша и 8 байт offset). Сравните с вариантом, в котором в карте хранится сам 36-символьный ключ. Проверьте, помещается ли в буфер миллион UUID-ключей из примера исходника.
▶ Решение (нажмите, чтобы открыть)
Ёмкость равна размеру буфера, умноженному на load factor и делённому на размер записи. Для варианта с хешем получается около 5,03 млн ключей, а для ключа в явном виде (36 + 8 = 44 байта) около 2,75 млн. Миллион ключей в буфер помещается с большим запасом.
# buffer_math.py · Python 3, стандартная библиотека
BUFFER = 128 * 1024 * 1024
LOAD_FACTOR = 0.9
HASH_ENTRY = 16 + 8
RAW_KEY_ENTRY = 36 + 8
UNIQUE_KEYS = 1_000_000


def capacity(entry_size, load=LOAD_FACTOR):
    return int(BUFFER * load // entry_size)


with_hash = capacity(HASH_ENTRY)
with_raw = capacity(RAW_KEY_ENTRY)

print("буфер, байт                 %d" % BUFFER)
print("запись с MD5-хешем          %d байта" % HASH_ENTRY)
print("без load factor             %d ключей" % capacity(HASH_ENTRY, 1.0))
print("с load factor %.1f          %d ключей" % (LOAD_FACTOR, with_hash))
print("ключ UUID хранится целиком  %d ключей" % with_raw)
print("выигрыш хеша                %.2f раза" % (with_hash / with_raw))
print("1 млн ключей помещается     %s" % (UNIQUE_KEYS <= with_hash))
буфер, байт                 134217728
запись с MD5-хешем          24 байта
без load factor             5592405 ключей
с load factor 0.9          5033164 ключей
ключ UUID хранится целиком  2745362 ключей
выигрыш хеша                1.83 раза
1 млн ключей помещается     True
Задание 2. Активный сегмент не компактируется
Запишите дубликаты в топик с segment.ms = 3000 и убедитесь, что они сохраняются, пока сегмент активен. Затем вызовите ролл сегмента и убедитесь, что дубликаты исчезают.
▶ Решение (нажмите, чтобы открыть)
Чтобы ролл сегмента произошёл наверняка, мы пишем в топик новую запись с ключом ping. Она попадает уже в следующий сегмент, а закрытый сегмент становится доступен cleaner’у. Контрольного прогона без ping у нас нет, поэтому утверждать, что одного ожидания по времени недостаточно, мы не можем. Счётчик «было» берётся до записи ping, то есть это 30 записей с дубликатами, и сравнивается с числом записей после очистки. В выводе остаются по одной последней записи ключей a, b, c и сама запись ping.
# active_segment.py · confluent-kafka 2.6.1 · Kafka 4.3.2
import time

from kafka_util import create_topic, produce, read_all, wait_compaction

TOPIC = "demo-active"

create_topic(TOPIC, {
    "cleanup.policy": "compact",
    "segment.ms": "3000",
    "min.cleanable.dirty.ratio": "0.01",
    "min.compaction.lag.ms": "0",
    "delete.retention.ms": "2000",
})

produce(TOPIC, [(key, "v%d" % i) for i in range(10) for key in ("a", "b", "c")])
time.sleep(10)
rows = read_all(TOPIC)
print("через 10 с без новых записей  записей=%d (дубликаты в активном сегменте)" % len(rows))

initial = len(rows)
produce(TOPIC, [("ping", "roll")])
count = wait_compaction(TOPIC, initial)
rows = read_all(TOPIC)
print("после ролла сегмента          записей=%d (было %d)" % (count, initial))
for offset, key, value in rows:
    print("  %3d %s %s" % (offset, key, value))
через 10 с без новых записей  записей=30 (дубликаты в активном сегменте)
после ролла сегмента          записей=4 (было 30)
   27 a v9
   28 b v9
   29 c v9
   30 ping roll
Здесь видно, что за десять секунд без новых записей все 30 записей остались на месте, а после записи ping их стало 4. Это согласуется с гипотезой об активном сегменте, но не доказывает её, потому что на результат могли влиять и другие факторы, например момент пробуждения cleaner. Offset выживших записей не изменились, а записи с 0 по 26 исчезли. Сам механизм ролла по segment.ms прогон прямо не доказывает, он показывает только согласованную с ним картину.
Задание 3. Tombstone и delete.retention.ms
Удалите ключ записью со значением null и посмотрите, когда запись исчезнет. Объясните, чем это опасно для консьюмера, который отстал дольше delete.retention.ms.
▶ Решение (нажмите, чтобы открыть)
Скрипт пишет ключи k1 и k2, затем обновляет k1 и удаляет k2. После этого раз в три секунды он добавляет запись tick. Каждая такая запись закрывает предыдущий сегмент (segment.ms = 2000) и даёт cleaner’у новую работу. На каждом шаге мы читаем топик целиком и смотрим, что осталось от k2.
# tombstone.py · confluent-kafka 2.6.1 · Kafka 4.3.2
import time

from kafka_util import create_topic, produce, read_all

TOPIC = "demo-tombstone"

create_topic(TOPIC, {
    "cleanup.policy": "compact",
    "segment.ms": "2000",
    "min.cleanable.dirty.ratio": "0.01",
    "min.compaction.lag.ms": "0",
    "delete.retention.ms": "5000",
})

produce(TOPIC, [("k1", "v1"), ("k2", "v2"), ("k1", "v1b"), ("k2", None)])
start = time.time()

for step in range(30):
    time.sleep(3)
    produce(TOPIC, [("tick", "t%d" % step)])
    rows = read_all(TOPIC)
    k1 = [value for _, key, value in rows if key == "k1"]
    k2 = [value for _, key, value in rows if key == "k2"]
    if not k2:
        state = "записей нет"
    elif k2[-1] is None:
        state = "tombstone"
    else:
        state = "значение " + k2[-1]
    print("t=%5.1f с  записей=%d  k1=%s  k2=%s" % (time.time() - start, len(rows), k1, state))
    if not k2:
        break
else:
    print("k2 не исчез за 90 с")
t=  3.1 с  записей=5  k1=['v1', 'v1b']  k2=tombstone
t=  6.1 с  записей=4  k1=['v1b']  k2=tombstone
t=  9.1 с  записей=5  k1=['v1b']  k2=tombstone
t= 12.2 с  записей=4  k1=['v1b']  k2=записей нет
Что видно в этом прогоне. К шестой секунде старая версия k1 уже убрана, а tombstone по k2 ещё лежит. На 9,1 с он всё ещё виден, то есть прожил дольше пяти секунд delete.retention.ms, а к 12,2 с исчез. Число записей при этом колеблется между 4 и 5, и этого колебания прогон не объясняет, потому что мы не выводили записи tick. Tombstone удаляется не по таймеру, а в очередном проходе cleaner после истечения retention, поэтому точное время исчезновения зависит от интервала опроса и от того, какой сегмент закрыт. Один прогон не позволяет делать выводы о типичной задержке, он лишь подтверждает порядок событий.
Чем это грозит. Tombstone нужен, чтобы консьюмеры, читающие лог, узнали об удалении и убрали ключ из своего состояния. Если консьюмер отстал настолько, что tombstone уже удалён cleaner’ом, он прочитает лог без записи об удалении и сохранит ключ, которого в системе уже нет. Поэтому delete.retention.ms должен превышать максимально допустимое отставание консьюмеров, а не выбираться как удобное значение.
Что дальше
Настройка cleaner, сегментов и tombstone на реальном кластере требует понимать, как параметры влияют друг на друга, и уметь диагностировать отставание очистки по метрикам. Это отрабатывается на практике в курсе по администрированию кластера Kafka.
Референсные ссылки
- Kafka as a KV Store, блог WarpStream. Исходная статья об алгоритме log compaction.
- Документация Apache Kafka, раздел Log Compaction.
- Документация Apache Kafka, параметр log.cleaner.dedupe.buffer.size.
- Документация Apache Kafka, параметр log.cleaner.io.buffer.load.factor.
- Документация Apache Kafka, параметр min.cleanable.dirty.ratio.