Kafka consumer time lag показывает, на сколько секунд данные у группы потребителей отстали от продюсера, и это единственная цифра, которую можно сразу назвать заказчику во время инцидента. Привычный offset lag говорит о числе сообщений, а сообщения у разных топиков весят по-разному. Идею time lag описала команда WarpStream. В статье мы разберём, как устроен time lag, посчитаем его на обычной Apache Kafka 4.3 через AdminClient и чтение записи по committed offset и проверим на стенде, где метрика работает хорошо, а где нет.
Почему offset lag плохо подходит для алертов
Offset lag считается просто. Из end offset партиции (офсет последней записанной записи) вычитается committed offset группы. Метрика полезна для одного потребителя, и по её динамике видно, помогло ли добавление консьюмеров. Клиент Java публикует похожий показатель сам, атрибут records-lag-max из consumer-fetch-manager-metrics, и документация Kafka описывает его как число сообщений, на которое потребитель отстаёт от продюсера.
Проблемы начинаются, когда нужен один порог на всех. Единица измерения у метрики разная для каждой нагрузки. На нашем стенде это видно сразу. Группа на топике с потоком 200 записей в секунду при отставании в 20 секунд имеет лаг 3999 офсетов, а группа на топике с потоком 2 записи в секунду при отставании в 25 секунд имеет лаг 48. Ожидаемые 4000 и 50 превратились в 3999 и 48 из-за целочисленного деления. Функция commit_group отступает от конца партиции на behind_records // PARTS записей, то есть 4000 // 3 = 1333 на партицию и 3999 на три, а для второй группы 50 // 3 = 16 и 48. Пакетные потребители копят лаг и вычитывают его разом, и для них любой порог либо молчит, либо звенит по ночам. Поэтому сравнивать группы между собой по offset lag нельзя.
Что говорит исходник про time lag
Команда WarpStream, которая продаёт совместимую с Kafka платформу поверх объектного хранилища, описала эту проблему в статье Kafka Consumer Lag Is the Wrong Metric. Автор показывает, что offset lag у разных групп в одной компании отличается на порядки и ничего не говорит об их здоровье, а потом предлагает мерить время.
Определение в исходнике такое. Time lag равен текущему времени минус момент, когда последняя прочитанная группой запись была самой свежей в топике. Тот же момент можно описать проще. Это время, прошедшее с создания следующей записи, которую группе ещё предстоит прочитать. Именно это определение мы реализуем в коде ниже, потому что timestamp следующей записи можно прочитать напрямую.
У определения есть полезное свойство. Метрика привязана к текущему времени, поэтому она растёт, даже если и продюсеры, и консьюмеры остановились, а непрочитанные записи остались. Система выглядит тихой, но метрика продолжает считать, и алерт срабатывает.
WarpStream реализует метрику внутри платформы. Метаданные там лежат в центральном хранилище и содержат индекс соответствия офсетов времени с точностью до минуты, поэтому метрика получается грубой и годится для алертов на минуты, а не для замера сквозной задержки. Этот индекс принадлежит платформе WarpStream, и в обычной Apache Kafka его нет. Зато идея переносится на любой кластер, и на обычной Kafka её можно реализовать иначе.
Как посчитать time lag на Apache Kafka
Формула через timestamp следующей записи
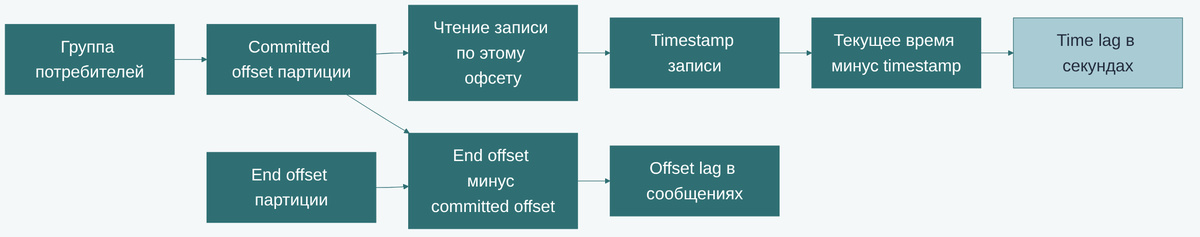
У каждой записи в Kafka есть timestamp. Значит, определение из исходника переносится почти буквально. Берём committed offset группы для партиции, читаем запись с этим офсетом, это следующая запись к обработке, и вычитаем её timestamp из текущего времени. Если committed offset равен end offset, непрочитанных записей нет и time lag равен нулю. Для группы с несколькими партициями берём максимум по партициям, потому что отставание группы определяет самая отстающая из них.
Все нужные данные доступны через публичные API из документации Kafka. Committed offsets возвращает Admin API, а запись по офсету читает обычный Consumer API через ручное назначение партиции без подписки на группу. Отдельный читающий клиент не вступает в группу и поэтому не вызывает ребалансировку.
Схема расчёта
На схеме показаны обе ветки. Offset lag считается из двух чисел, time lag требует дополнительного чтения одной записи на партицию.
Ограничения метрики и выбор подхода
Сначала сведём подходы в таблицу. В ней три варианта, которые мы можем описать по исходнику и по стенду этой статьи.
| Критерий | Offset lag | Time lag по timestamp записи | Оценка по индексу минутных интервалов (WarpStream) |
|---|---|---|---|
| Единица измерения | сообщения | секунды | секунды |
| Сопоставимость между группами | нет, зависит от throughput | да | да |
| Чтение записей с брокера | не нужно | одна запись на партицию за проверку | не нужно, используются метаданные |
| Зависимость от timestamp клиента | нет | да, для CreateTime | нет, индекс ведёт сама платформа |
| Точность | точное число сообщений | точная до timestamp записи | грубая, интерполяция внутри минуты |
| Остановка продюсера | значение замирает | продолжает расти | продолжает расти |
Offset lag выигрывает там, где нужна дешёвая метрика для одного потребителя и анализ динамики. Time lag по timestamp записи даёт сопоставимое число на обычной Kafka без внешних сервисов, но платит за это чтением записи. Оценка по индексу удобна, когда платформа ведёт такой индекс сама, и у обычной Kafka её нет. Готовые сторонние сервисы мониторинга тоже умеют считать time lag, но это ещё один сервис, который нужно развернуть и сопровождать, и на такой выбор влияет, есть ли у вас команда под него.
Теперь об ограничениях, которые не зависят от выбора инструмента.
- Тип timestamp. Топик с CreateTime хранит время, которое поставил клиент. Продюсер с неверными часами или с исторической загрузкой искажает метрику. В режиме
LogAppendTimeвремя ставит брокер при записи, и метрика честнее показывает задержку в Kafka, но теряет связь с временем события. - Интервал коммита. Метрика строится по committed offsets, а они отстают от реального чтения. Потребитель, который коммитит раз в минуту, всегда будет казаться отстающим на эту минуту.
- Пустые партиции. Если committed offset равен end offset, читать нечего и лаг нулевой. В расчёте для этого стоит явная проверка committed < high, и в коде она вынесена отдельно, чтобы не вызывать чтение там, где записи нет.
- Срок жизни committed offsets. По документации брокера параметр
offsets.retention.minutesпо умолчанию равен 10080, то есть семи суткам. Для группы без участников это время отсчитывается с момента, когда она опустела. После истечения коммитов метрике считать нечего.
Эти ограничения не отменяют метрику. Они определяют, для чего её использовать, а именно для алертов на отставание в минутах, а не для замера задержки в миллисекундах.
Практика. Считаем time lag на стенде
Стенд состоит из одного брокера Kafka 4.3.2 в режиме KRaft и клиентского кода на Python в виртуальном окружении. Брокер ограничен по памяти 1 ГБ, порт открыт только на 127.0.0.1. Версия клиента confluent-kafka 2.6.1 закреплена в requirements.txt, чтобы прогон повторялся на любой машине с теми же результатами. Все вызовы из примера (AdminClient, чтение по ручному назначению партиции, коммит офсетов) относятся к стабильным частям клиентского протокола. Основы работы потребителей и коммитов офсетов мы разбираем на курсе Apache Kafka для разработчиков, здесь они нужны только в минимальном объёме.
Сначала описание стенда.
# compose.yaml · apache/kafka:4.3.2
services:
  kafka:
    image: apache/kafka:4.3.2
    mem_limit: 1g
    ports:
      - "127.0.0.1:9092:9092"
    environment:
      KAFKA_NODE_ID: 1
      KAFKA_PROCESS_ROLES: broker,controller
      KAFKA_LISTENERS: PLAINTEXT://:9092,CONTROLLER://:9093
      KAFKA_ADVERTISED_LISTENERS: PLAINTEXT://127.0.0.1:9092
      KAFKA_CONTROLLER_LISTENER_NAMES: CONTROLLER
      KAFKA_LISTENER_SECURITY_PROTOCOL_MAP: CONTROLLER:PLAINTEXT,PLAINTEXT:PLAINTEXT
      KAFKA_CONTROLLER_QUORUM_VOTERS: 1@localhost:9093
      KAFKA_OFFSETS_TOPIC_REPLICATION_FACTOR: 1
      KAFKA_TRANSACTION_STATE_LOG_REPLICATION_FACTOR: 1
      KAFKA_TRANSACTION_STATE_LOG_MIN_ISR: 1
      KAFKA_GROUP_INITIAL_REBALANCE_DELAY_MS: 0
      KAFKA_HEAP_OPTS: -Xms512m -Xmx512m
    healthcheck:
      test: ["CMD", "/opt/kafka/bin/kafka-broker-api-versions.sh", "--bootstrap-server", "127.0.0.1:9092"]
      interval: 5s
      timeout: 10s
      retries: 20
      start_period: 15s
# requirements.txt
confluent-kafka==2.6.1
#!/usr/bin/env bash
# run.sh · Kafka 4.3.2 · confluent-kafka 2.6.1
set -euo pipefail
docker compose up -d --wait
python3 -m venv .venv
.venv/bin/pip install -q -r requirements.txt
.venv/bin/python demo.py
Общая библиотека lag_lib.py делает всю работу. Функция seed пишет записи с заданными timestamp, commit_group выставляет группе committed offsets без запуска настоящих консьюмеров, collect собирает по каждой партиции committed offset, end offset и timestamp следующей записи, а summary сворачивает это в два числа. Проверка committed < high гарантирует, что для догнавшей партиции чтение не выполняется и лаг получается нулевым.
# lag_lib.py · confluent-kafka 2.6.1 · Kafka 4.3.2
import time

from confluent_kafka import Consumer, ConsumerGroupTopicPartitions, KafkaError, KafkaException, Producer, TopicPartition
from confluent_kafka.admin import AdminClient, NewTopic

BOOTSTRAP = "127.0.0.1:9092"
PARTS = 3


def create_topic(name, config=None):
    admin = AdminClient({"bootstrap.servers": BOOTSTRAP})
    future = admin.create_topics(
        [NewTopic(name, num_partitions=PARTS, replication_factor=1, config=config or {})]
    )[name]
    try:
        future.result()
    except KafkaException as e:
        if e.args[0].code() != KafkaError.TOPIC_ALREADY_EXISTS:
            raise


def seed(topic, n, first_ts_ms, step_ms):
    producer = Producer({"bootstrap.servers": BOOTSTRAP, "linger.ms": 20})
    for i in range(n):
        producer.produce(topic, value=b"x", partition=i % PARTS,
                         timestamp=int(first_ts_ms + i * step_ms))
        if i % 1000 == 0:
            producer.poll(0)
    producer.flush(30)


def commit_group(group, topic, behind_records):
    consumer = Consumer({"bootstrap.servers": BOOTSTRAP, "group.id": group,
                         "enable.auto.commit": False})
    offsets = []
    for p in range(PARTS):
        low, high = consumer.get_watermark_offsets(TopicPartition(topic, p), timeout=10)
        offsets.append(TopicPartition(topic, p, max(low, high - behind_records // PARTS)))
    retriable = (KafkaError.NOT_COORDINATOR, KafkaError.COORDINATOR_NOT_AVAILABLE,
                 KafkaError.COORDINATOR_LOAD_IN_PROGRESS)
    deadline = time.time() + 60
    while True:
        try:
            consumer.commit(offsets=offsets, asynchronous=False)
            break
        except KafkaException as e:
            if e.args[0].code() not in retriable or time.time() > deadline:
                raise
            time.sleep(1)
    consumer.close()


def make_probe():
    return Consumer({"bootstrap.servers": BOOTSTRAP, "group.id": "lag-probe",
                     "enable.auto.commit": False, "auto.offset.reset": "earliest"})


def collect(group, probe):
    admin = AdminClient({"bootstrap.servers": BOOTSTRAP})
    result = admin.list_consumer_group_offsets([ConsumerGroupTopicPartitions(group)])[group].result()
    rows = []
    for tp in sorted(result.topic_partitions, key=lambda t: (t.topic, t.partition)):
        low, high = probe.get_watermark_offsets(TopicPartition(tp.topic, tp.partition), timeout=10)
        committed = tp.offset if tp.offset >= 0 else low
        ts = None
        if committed < high:
            probe.assign([TopicPartition(tp.topic, tp.partition, committed)])
            deadline = time.time() + 15
            while ts is None and time.time() < deadline:
                msg = probe.poll(1.0)
                if msg is not None and msg.error() is None and msg.partition() == tp.partition:
                    ts = msg.timestamp()[1]
            probe.unassign()
            if ts is None:
                raise RuntimeError(f"нет записи {tp.topic}[{tp.partition}] по офсету {committed}")
        rows.append((tp.topic, tp.partition, committed, high, ts))
    return rows


def summary(rows):
    now = time.time()
    offset_lag = sum(end - committed for _, _, committed, end, _ in rows)
    time_lag = max((now - ts / 1000 for *_, ts in rows if ts is not None), default=0.0)
    return offset_lag, max(time_lag, 0.0)
Основной сценарий создаёт два топика. Топик demo-clicks получает 200 записей в секунду за последнюю минуту, а demo-payments получает 2 записи в секунду. Группа clicks-app отстаёт на 20 секунд потока, а payments-app на 25 секунд. Таймстемпы расставлены задним числом, поэтому прогон занимает секунды, а не минуты. Затем скрипт печатает таблицу, ждёт 5 секунд при остановленных продюсерах и печатает её снова.
# demo.py · confluent-kafka 2.6.1 · Kafka 4.3.2
import time

import lag_lib as L

HISTORY_S = 60
GROUPS = [
    ("clicks-app", "demo-clicks", 200, 20),
    ("payments-app", "demo-payments", 2, 25),
]

now_ms = int(time.time() * 1000)
for group, topic, rate, behind_s in GROUPS:
    L.create_topic(topic)
    L.seed(topic, rate * HISTORY_S, now_ms - HISTORY_S * 1000, 1000 / rate)
    L.commit_group(group, topic, behind_s * rate)

probe = L.make_probe()


def show(title):
    print(title)
    print(f"{'group':<14}{'offset lag':>12}{'time lag, s':>13}")
    for group, _, _, _ in GROUPS:
        offset_lag, seconds = L.summary(L.collect(group, probe))
        print(f"{group:<14}{offset_lag:>12}{seconds:>13.1f}")


show("Сразу после записи")
time.sleep(5)
show("Через 5 секунд, продюсеры остановлены")
Сразу после записи
group           offset lag  time lag, s
clicks-app            3999         21.2
payments-app            48         26.7
Через 5 секунд, продюсеры остановлены
group           offset lag  time lag, s
clicks-app            3999         28.8
payments-app            48         34.3
Стенд показал две вещи. Во-первых, offset lag групп отличается примерно в 83 раза, 3999 против 48, потому что у топиков разный поток. Во-вторых, time lag сопоставим для обеих групп и составил 21.2 и 26.7 секунды при заданных 20 и 25 секундах потока. Превышение в 1.2 и 1.7 секунды, вероятно, набралось за время записи, коммита и расчёта между расстановкой таймстемпов и замером. Прогон эти составляющие не разделяет, поэтому это предположение, а не измеренный факт.
Во второй таблице offset lag остался прежним, потому что никто ничего не пишет и не читает. Time lag вырос на 7.6 секунды у каждой группы, с 21.2 до 28.8 и с 26.7 до 34.3. Рост больше паузы в 5 секунд на 2.6 секунды, и причина видна из кода. Между двумя замерами одной группы проходит не только sleep, но и работа collect и вывод строк для обеих групп, включая чтение записи по каждой партиции. Эти составляющие по отдельности мы не мерили, поэтому точную долю каждой назвать нельзя. Замер подтверждает главное, что значение продолжает расти при остановленных продюсерах, а не стоит на месте, как offset lag.
Что прогон не доказывает. Committed offsets мы выставили напрямую, и поэтому влияние интервала коммита настоящего потребителя здесь не видно. Нагрузку расчёта на брокер мы тоже не измеряли, замер по одному брокеру ничего не скажет о кластере с тысячами партиций. Стенд показывает механику метрики, а не производительность.
Задания
Задания используют ту же lag_lib.py. Каждое работает на своих топиках и группах, поэтому их можно запускать в любом порядке.
Задание 1. Единый порог для групп с разным потоком
Создайте высокоинтенсивный топик с группой, отстающей на небольшое время, и редкий топик с группой, отстающей надолго. Задайте один порог в секундах и сравните его с порогом в офсетах.
▶ Решение (нажмите, чтобы открыть)
# task1_alert.py · confluent-kafka 2.6.1 · Kafka 4.3.2
import time

import lag_lib as L

HISTORY_S = 120
THRESHOLD_S = 60
THRESHOLD_OFFSETS = 1000
GROUPS = [
    ("t1-clicks-app", "t1-clicks", 200, 15),
    ("t1-payments-app", "t1-payments", 2, 90),
]

now_ms = int(time.time() * 1000)
for group, topic, rate, behind_s in GROUPS:
    L.create_topic(topic)
    L.seed(topic, rate * HISTORY_S, now_ms - HISTORY_S * 1000, 1000 / rate)
    L.commit_group(group, topic, behind_s * rate)

probe = L.make_probe()
print(f"{'group':<18}{'offsets':>9}{'seconds':>9}  {'alert by offsets':<18}alert by time")
for group, _, _, _ in GROUPS:
    offset_lag, seconds = L.summary(L.collect(group, probe))
    by_offsets = "ALERT" if offset_lag > THRESHOLD_OFFSETS else "ok"
    by_time = "ALERT" if seconds > THRESHOLD_S else "ok"
    print(f"{group:<18}{offset_lag:>9}{seconds:>9.1f}  {by_offsets:<18}{by_time}")
group               offsets  seconds  alert by offsets  alert by time
t1-clicks-app          3000     16.5  ALERT             ok
t1-payments-app         180     92.5  ok                ALERT
Порог в офсетах поднимает тревогу на группе с большим потоком, которая отстала всего на 16.5 секунды, и молчит на группе, которая отстала на полторы минуты. Порог в секундах выбирает именно её.
Задание 2. Догнавшая группа и новая запись
Убедитесь, что у группы с committed offset, равным end offset, time lag равен нулю. Затем запишите одну запись, не читайте её и проследите, как лаг растёт.
▶ Решение (нажмите, чтобы открыть)
# task2_caught_up.py · confluent-kafka 2.6.1 · Kafka 4.3.2
import time

import lag_lib as L

TOPIC, GROUP = "t2-orders", "t2-orders-app"

now_ms = int(time.time() * 1000)
L.create_topic(TOPIC)
L.seed(TOPIC, 30, now_ms - 30000, 1000)
L.commit_group(GROUP, TOPIC, 0)

probe = L.make_probe()


def show(label):
    offset_lag, seconds = L.summary(L.collect(GROUP, probe))
    print(f"{label:<32}{offset_lag:>6}{seconds:>9.1f}")


show("группа догнала")
L.seed(TOPIC, 1, int(time.time() * 1000), 0)
time.sleep(3)
show("запись не прочитана, 3 с")
time.sleep(2)
show("запись не прочитана, 5 с")
группа догнала                       0      0.0
запись не прочитана, 3 с             1      3.5
запись не прочитана, 5 с             1      6.1
Нулевой лаг у догнавшей группы получается благодаря проверке committed < high в collect. После появления непрочитанной записи отсчёт идёт от её timestamp, и значение растёт с каждой секундой.
Задание 3. CreateTime против LogAppendTime
Создайте два топика, один со стандартным CreateTime и один с параметром message.timestamp.type=LogAppendTime. Запишите в оба записи с timestamp на час в прошлом и сравните time lag групп, которые ничего не прочитали.
▶ Решение (нажмите, чтобы открыть)
# task3_timestamp_type.py · confluent-kafka 2.6.1 · Kafka 4.3.2
import time

import lag_lib as L

TOPICS = [
    ("t3-create-time", None, "t3-create-app"),
    ("t3-append-time", {"message.timestamp.type": "LogAppendTime"}, "t3-append-app"),
]

now_ms = int(time.time() * 1000)
for topic, config, group in TOPICS:
    L.create_topic(topic, config)
    L.seed(topic, 30, now_ms - 3600 * 1000, 1000)
    L.commit_group(group, topic, 30)

probe = L.make_probe()
print(f"{'topic':<18}{'offset lag':>12}{'time lag, s':>13}")
for topic, _, group in TOPICS:
    offset_lag, seconds = L.summary(L.collect(group, probe))
    print(f"{topic:<18}{offset_lag:>12}{seconds:>13.1f}")
topic               offset lag  time lag, s
t3-create-time              30       3602.5
t3-append-time              30          2.7
В топике с CreateTime метрика унаследовала искажённое клиентское время и показала 3602.5 секунды, то есть около часа. В топике с LogAppendTime брокер заменил время клиента временем записи, и лаг составил 2.7 секунды при том же offset lag, равном 30.
Мониторинг групп потребителей, пороги для алертов и работа с метриками брокера подробно разбираются на курсе Администрирование кластера Kafka, где мы собираем такие проверки на реальном кластере.