Если Kafka consumer lag растёт, хотя процесс консьюмера жив, партиции назначены и в брокере нет ошибок, причину стоит искать не в Apache Kafka, а в том, что консьюмер делает с каждым сообщением. Частый виновник это блокировка одной строки в PostgreSQL, через которую вынуждены проходить все события популярного клиента. Ниже разберём, как отличить такой случай от нехватки консьюмеров, что происходит с офсетами при медленной обработке, а затем воспроизведём проблему на стенде с шестью партициями и сравним три способа записи в базу.
Консьюмер жив, а сообщения опаздывают
Картина знакомая. Проверка живости зелёная, группа стабильна, брокер не жалуется, а событие, которое должно обрабатываться за секунды, доходит до результата через десятки минут. Первая реакция почти всегда одна, добавить консьюмеров. Это работает, когда существующие консьюмеры упёрлись в процессор и есть свободные партиции. Это почти не работает, когда все консьюмеры ждут одного и того же ресурса.
Поэтому диагностику начинаем не с настроек Kafka, а с двух чисел. Первое, сколько сообщений в секунду приходит в топик. Второе, сколько сообщений в секунду группа успевает довести до конца. Пока второе число меньше первого, очередь растёт, и никакая перенастройка брокера этого не изменит.
Как читать lag и считать темп погашения
Что показывает lag
Задержка консьюмера (consumer lag) это разность между концом журнала партиции (log end offset) и позицией группы (committed offset). Документация Kafka объясняет, почему позиция так дёшево хранится. Партиция в рамках группы читается ровно одним консьюмером, поэтому позиция это одно число, смещение (offset) следующего сообщения. Утилита kafka-consumer-groups.sh с флагом —describe выводит по каждой партиции колонки CURRENT-OFFSET, LOG-END-OFFSET и LAG.
Есть оговорка, которую легко пропустить. Lag считается от закоммиченной позиции, поэтому в нём остаются сообщения, которые консьюмер уже обработал, но ещё не подтвердил. Чем реже коммиты, тем сильнее lag завышает отставание.
Темп погашения
Одно значение lag мало что говорит, важна динамика. Обозначим приток R_in, а скорость обработки группой R_out, обе в сообщениях в секунду. Время погашения очереди равно lag, делённому на разность R_out и R_in. Если R_out не превышает R_in, очередь не погасится никогда. Условный пример для арифметики. Очередь 60 000 сообщений, приток 300 в секунду, обработка 800 в секунду, значит на погашение уйдёт 60 000 / 500 = 120 секунд, и всё это время группа ещё и принимает новые события.
Важно, что R_out нужно мерить на стороне приложения, а не выводить из числа консьюмеров. Именно R_out ограничивается самым медленным общим ресурсом на пути обработки.
Метрики консьюмера, которые отвечают на вопрос где время
Документация по мониторингу рекомендует следить на стороне консьюмера за максимальным lag по всем партициям и за минимальной частотой fetch-запросов. Чтобы консьюмер справлялся, максимальный lag должен быть ниже порога, а частота fetch больше нуля. Для поиска узкого места полезны ещё три метрики из группы consumer-metrics и consumer-fetch-manager-metrics:
- records-lag-max. Максимальный lag по партициям консьюмера. Показывает масштаб проблемы и перекос между партициями.
- poll-idle-ratio-avg. Средняя доля времени, когда
poll()простаивает, а не ждёт пользовательский код. Значение около нуля означает, что почти всё время уходит в обработку записей. - time-between-poll-max. Максимальная пауза между вызовами
poll(). Если она подбирается кmax.poll.interval.ms, то при классическом протоколе группы консьюмера исключат из группы и начнётся ребалансировка. Этого поведения стенд не проверял.
Если poll-idle-ratio-avg близка к нулю, а процессор консьюмера при этом свободен, значит время уходит на ожидание внешней системы, и смотреть нужно туда.
Что происходит с офсетами при медленной обработке
Прежде чем лечить базу, стоит понять, что гарантирует сам консьюмер. Документация описывает три варианта. Если сначала сохранить позицию, а потом обработать сообщения, получим at-most-once, потому что при сбое между этими шагами часть сообщений потеряется. Если сначала обработать, а потом сохранить позицию, получим at-least-once, потому что при сбое между шагами новый владелец партиции прочитает уже обработанные сообщения повторно. Для записи в базу почти всегда выбирают второй вариант и принимают повторы как данность.
Отсюда два следствия. Первое, повторная доставка случается не только при падении. Ребалансировка тоже может привести к повтору. Если перед отзывом партиций коммит не выполнен, новый владелец начнёт с последней закоммиченной позиции и снова прочитает всё обработанное после неё. Поэтому консьюмер на стенде коммитит офсет в обработчике отзыва партиций (on_revoke), чтобы сократить число повторов. Второе, коммит в Kafka и коммит в PostgreSQL это две разные системы без общей атомарной транзакции. Транзакция базы данных защищает только базу и не делает офсет частью той же фиксации. Поэтому запись в базу обязана быть идемпотентной (idempotent), то есть повторная обработка того же события не должна менять результат. Документация замечает, что у многих сообщений есть первичный ключ, и тогда повторное обновление просто перезаписывает запись самой собой.
Частота коммитов это компромисс. Редкие коммиты дешевле, но после сбоя дольше перечитывать. Частые коммиты уменьшают окно повторов, но добавляют запросов к координатору группы.
Горячая строка в PostgreSQL и почему больше консьюмеров не помогает
Очередь на одной строке
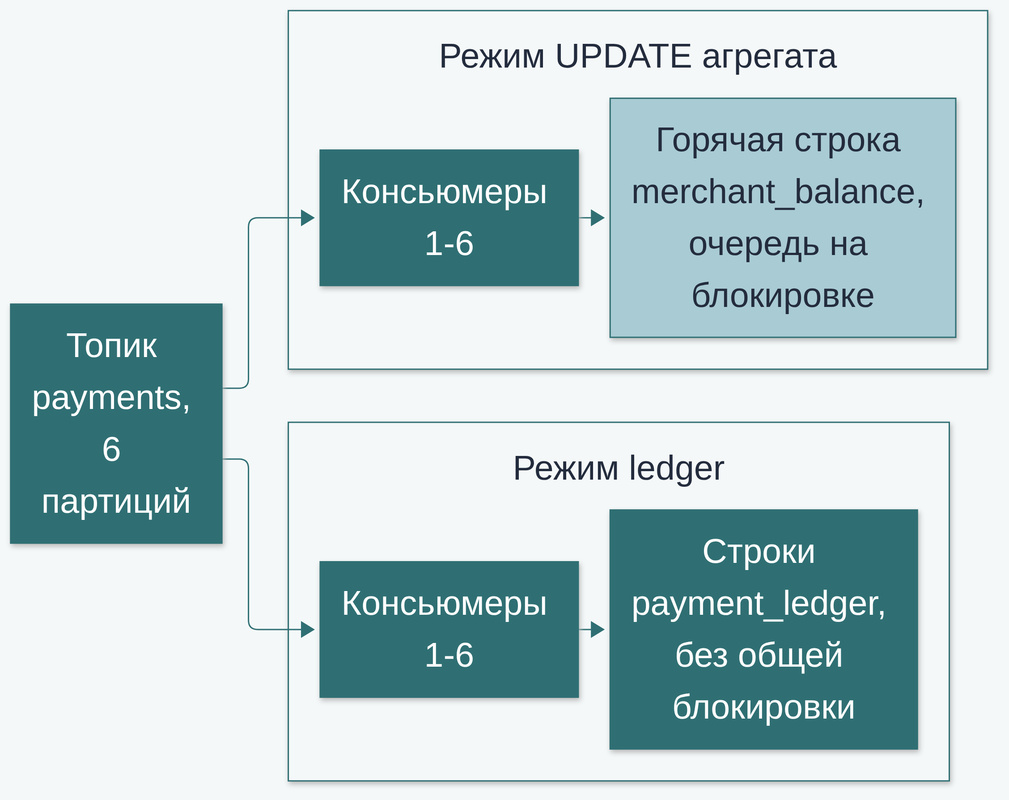
Допустим, консьюмер на каждое платёжное событие выполняет обновление агрегата вида UPDATE merchant_balance SET pending_amount = pending_amount + :amount WHERE merchant_id = :id. Запрос простой, строка найдена по первичному ключу, недостающего индекса нет. Проблема появляется, когда большая доля событий принадлежит одному клиенту. Такая строка называется горячей (hot row).
UPDATE берёт блокировку строки (row-level lock) и держит её до конца транзакции. Остальные транзакции, которые хотят изменить ту же строку, ждут фиксации или отката первой. Чем дольше транзакция живёт после самого UPDATE, например делает вставку в журнал аудита или вызывает другой сервис, тем длиннее очередь. Все остальные строки при этом обновляются свободно, поэтому средняя нагрузка на базу выглядит скромной.
Как это увидеть в pg_stat_activity
Представление pg_stat_activity показывает для каждой сессии тип и название ожидания. Сессия, которая ждёт чужую транзакцию, получает wait_event_type Lock и, как правило, wait_event transactionid или tuple. Если периодически снимать срезы и группировать сессии по этим двум колонкам, то у горячей строки будет видна доля Lock. В прогоне ниже так и вышло. В режиме hot по числу сессий лидирует Lock/transactionid, за ним идут Client/ClientRead и Lock/tuple. В режиме ledger строк Lock в срезах нет совсем, там остаются ClientRead и ожидания записи WAL.
Потолок пропускной способности
Оценить предел можно арифметикой. Если транзакция держит горячую строку 5 миллисекунд, то строка обновляется не чаще 200 раз в секунду, и число консьюмеров на это число не влияет. Если 60 процентов событий приходятся на один ключ, то общий поток не превысит примерно 200 / 0,6, то есть около 330 событий в секунду. Это оценка сверху из параметров нашего стенда, а не замер. Измеренные в режиме hot 135 событий в секунду в 2,4 раза ниже этой оценки, то есть она не достигнута и служит только верхней границей. Без общей строки транзакции разных событий не ждут друг друга, поэтому потолок должен расти с числом консьюмеров. Прогон это не проверял, число консьюмеров в нём не менялось.
Отдельно нужно упомянуть перекос по партициям. Если ключом сообщения выбран идентификатор клиента, все события горячего клиента попадут в одну партицию, а её читает один консьюмер, что даёт ещё одно узкое место независимо от базы. Документация Kafka прямо говорит, что ключ задаёт партицию и нужен для локальности обработки. На стенде мы ключуем сообщения по идентификатору события, чтобы изолировать именно эффект блокировки.
Сравнение способов записи в БД из консьюмера
Есть три типовых способа записать результат события. Первый, обновлять агрегат на каждое событие. Второй, вставлять неизменяемую запись в журнал (ledger) с ограничением уникальности по идентификатору события и оператором ON CONFLICT DO NOTHING, а баланс считать отдельным процессом. Третий, накопить батч, свернуть его по клиентам и сделать один UPDATE на клиента за транзакцию.
| Критерий | UPDATE на каждое событие | Ledger с ON CONFLICT DO NOTHING | Один UPDATE на клиента за батч |
|---|---|---|---|
| Конкуренция за строку | Высокая, очередь на одной строке | Нет общей строки | Строка клиента общая, прогон не разбирал |
| Идемпотентность при повторе | Нет, повтор прибавит сумму | Да, повтор с тем же event_id игнорируется |
Нет, повтор батча прибавит суммы |
| Сложность | Минимальная | Нужна агрегация с контрольной точкой | Средняя, нужна свёртка батча |
| Согласованность баланса | Баланс актуален при фиксации | Баланс производный, отстаёт от журнала | Баланс отстаёт не больше чем на батч |
| Масштабирование по консьюмерам | Упирается в горячую строку | Должен расти, прогон это не проверял | Рост не измерялся, прогон показал выигрыш в скорости |
Первый способ годится, пока нет перекоса по ключам и транзакция короткая. Он проще всего и даёт актуальный баланс сразу, но не терпит повторов и плохо переживает горячий ключ. Ledger решает обе проблемы ценой того, что баланс становится проекцией, а не источником истины. Если по балансу разрешают списания или проверяют лимиты, одной отложенной агрегации недостаточно, и для таких решений нужен отдельный транзакционный механизм. Батч по идемпотентности и сложности занимает середину, потому что идемпотентность в нём придётся строить отдельно, например хранить идентификаторы событий рядом. По скорости в нашем стенде он оказался впереди (см. задание 2), но это следствие устройства примера, а именно пауза в 5 миллисекунд приходится на пачку, а не на событие. Поэтому цифры батча не стоит переносить на систему, где транзакция стоит дороже паузы.
Практика. Стенд с Kafka, PostgreSQL и двумя режимами консьюмера
Стенд состоит из одного брокера Kafka 4.3.2 в режиме KRaft и PostgreSQL 16.4, у каждого сервиса лимит памяти 1 ГБ, порты открыты только на 127.0.0.1. Файл compose.yaml целиком.
# compose.yaml · apache/kafka 4.3.2 (KRaft) · postgres 16.4
services:
  kafka:
    image: apache/kafka:4.3.2
    mem_limit: 1g
    ports:
      - "127.0.0.1:9092:9092"
    environment:
      KAFKA_NODE_ID: 1
      KAFKA_PROCESS_ROLES: broker,controller
      KAFKA_LISTENERS: PLAINTEXT://:9092,CONTROLLER://:9093
      KAFKA_ADVERTISED_LISTENERS: PLAINTEXT://127.0.0.1:9092
      KAFKA_CONTROLLER_LISTENER_NAMES: CONTROLLER
      KAFKA_LISTENER_SECURITY_PROTOCOL_MAP: CONTROLLER:PLAINTEXT,PLAINTEXT:PLAINTEXT
      KAFKA_CONTROLLER_QUORUM_VOTERS: 1@localhost:9093
      KAFKA_OFFSETS_TOPIC_REPLICATION_FACTOR: 1
      KAFKA_TRANSACTION_STATE_LOG_REPLICATION_FACTOR: 1
      KAFKA_TRANSACTION_STATE_LOG_MIN_ISR: 1
      KAFKA_GROUP_INITIAL_REBALANCE_DELAY_MS: 3000
    healthcheck:
      test: ["CMD-SHELL", "/opt/kafka/bin/kafka-topics.sh --bootstrap-server localhost:9092 --list"]
      interval: 5s
      timeout: 10s
      retries: 20
  postgres:
    image: postgres:16.4
    mem_limit: 1g
    ports:
      - "127.0.0.1:5432:5432"
    environment:
      POSTGRES_USER: demo
      POSTGRES_PASSWORD: demo
      POSTGRES_DB: shop
    healthcheck:
      test: ["CMD-SHELL", "pg_isready -U demo -d shop"]
      interval: 5s
      timeout: 5s
      retries: 20
Зависимости клиента лежат в requirements.txt, а запуск описан в run.sh. Скрипт поднимает стенд, ставит пакеты в .venv и запускает основной пример.
# requirements.txt
confluent-kafka==2.6.1
psycopg[binary]==3.2.3
#!/usr/bin/env bash
# run.sh · Docker Compose · Python 3.12 · Kafka 4.3.2 · PostgreSQL 16.4
set -euo pipefail
cd "$(dirname "$0")"
docker compose up -d --wait
python3 -m venv .venv
.venv/bin/pip install --quiet -r requirements.txt
.venv/bin/python bench.py
Основной файл bench.py устроен так. Скрипт создаёт топик payments на 6 партиций и записывает 6000 событий, из которых 60 процентов принадлежат клиенту с номером 1, а остальные размазаны по 49 клиентам. Сообщения ключуются идентификатором события, поэтому партиции заполнены ровно. Затем шесть потоков-консьюмеров, каждый со своим соединением с PostgreSQL, читают топик в двух режимах. В режиме hot консьюмер делает UPDATE агрегата на каждое событие. В режиме ledger он вставляет строку с ON CONFLICT DO NOTHING. В обоих режимах транзакция после основной операции 5 миллисекунд занята другой работой, чтобы смоделировать вызов соседнего сервиса или запись аудита, а офсет коммитится синхронно после каждых 50 обработанных сообщений. Поток-репортёр каждые 3 секунды печатает lag, один раз вызывает kafka-consumer-groups.sh внутри контейнера, а главный поток раз в секунду снимает срез ожиданий из pg_stat_activity.
# bench.py · confluent-kafka 2.6.1 · psycopg 3.2.3 · Kafka 4.3.2 · PostgreSQL 16.4
import json
import subprocess
import threading
import time
import uuid
from collections import Counter
from decimal import Decimal
from pathlib import Path

import psycopg
from confluent_kafka import Consumer, KafkaException, Producer, TopicPartition
from confluent_kafka.admin import AdminClient, NewTopic

BOOTSTRAP = "127.0.0.1:9092"
DSN = "host=127.0.0.1 port=5432 dbname=shop user=demo password=demo"
TOPIC = "payments"
PARTITIONS = 6
WORKERS = 6
EVENTS = 6000
MERCHANTS = 50
WORK_MS = 5
COMMIT_EVERY = 50
NS = uuid.UUID("12345678-1234-5678-1234-567812345678")

WAIT_SQL = """
SELECT coalesce(wait_event_type, 'CPU'), coalesce(wait_event, 'running'), count(*)
FROM pg_stat_activity
WHERE datname = 'shop' AND pid <> pg_backend_pid()
  AND state IN ('active', 'idle in transaction')
GROUP BY 1, 2
ORDER BY 3 DESC
"""


def make_event(i):
    hot = i % 10 < 6
    merchant = 1 if hot else 2 + (i // 10) % (MERCHANTS - 1)
    return {
        "event_id": str(uuid.uuid5(NS, f"evt-{i}")),
        "merchant_id": merchant,
        "amount": f"{1 + i % 7}.00",
    }


TOTAL = sum(Decimal(make_event(i)["amount"]) for i in range(EVENTS))


def ensure_topic():
    admin = AdminClient({"bootstrap.servers": BOOTSTRAP})
    new_topic = NewTopic(TOPIC, num_partitions=PARTITIONS, replication_factor=1)
    for future in admin.create_topics([new_topic]).values():
        try:
            future.result()
        except KafkaException:
            pass


def make_consumer(group, client_id):
    return Consumer({
        "bootstrap.servers": BOOTSTRAP,
        "group.id": group,
        "client.id": client_id,
        "enable.auto.commit": False,
        "auto.offset.reset": "earliest",
    })


def topic_size():
    consumer = make_consumer("probe", "probe")
    try:
        for _ in range(10):
            try:
                total = 0
                for p in range(PARTITIONS):
                    low, high = consumer.get_watermark_offsets(TopicPartition(TOPIC, p), timeout=10)
                    total += high - low
                return total
            except KafkaException:
                time.sleep(1)
        raise RuntimeError("топик недоступен")
    finally:
        consumer.close()


def seed():
    producer = Producer({"bootstrap.servers": BOOTSTRAP, "linger.ms": 20})
    for i in range(EVENTS):
        event = make_event(i)
        producer.produce(TOPIC, key=event["event_id"], value=json.dumps(event))
        if i % 1000 == 0:
            producer.poll(0)
    producer.flush(30)


def reset_db():
    with psycopg.connect(DSN, autocommit=True) as conn:
        conn.execute("DROP TABLE IF EXISTS merchant_balance, payment_ledger")
        conn.execute(
            "CREATE TABLE merchant_balance ("
            "merchant_id BIGINT PRIMARY KEY, "
            "pending_amount NUMERIC(19, 2) NOT NULL DEFAULT 0)"
        )
        conn.execute(
            "CREATE TABLE payment_ledger ("
            "event_id UUID PRIMARY KEY, "
            "merchant_id BIGINT NOT NULL, "
            "amount NUMERIC(19, 2) NOT NULL, "
            "created_at TIMESTAMPTZ NOT NULL DEFAULT now())"
        )
        conn.execute(
            "INSERT INTO merchant_balance SELECT g, 0 FROM generate_series(1, %s) AS g",
            (MERCHANTS,),
        )


def apply_hot(conn, event):
    with conn.transaction():
        conn.execute(
            "UPDATE merchant_balance SET pending_amount = pending_amount + %s "
            "WHERE merchant_id = %s",
            (event["amount"], event["merchant_id"]),
        )
        time.sleep(WORK_MS / 1000)


def apply_ledger(conn, event):
    with conn.transaction():
        conn.execute(
            "INSERT INTO payment_ledger (event_id, merchant_id, amount) "
            "VALUES (%s, %s, %s) ON CONFLICT (event_id) DO NOTHING",
            (event["event_id"], event["merchant_id"], event["amount"]),
        )
        time.sleep(WORK_MS / 1000)


APPLY = {"hot": apply_hot, "ledger": apply_ledger}


def safe_commit(consumer):
    try:
        consumer.commit(asynchronous=False)
    except KafkaException:
        pass


def on_revoke(consumer, partitions):
    safe_commit(consumer)


def worker(mode, group, stop, counters, idx):
    consumer = make_consumer(group, f"{mode}-{idx}")
    conn = psycopg.connect(DSN, autocommit=True)
    consumer.subscribe([TOPIC], on_revoke=on_revoke)
    apply = APPLY[mode]
    pending = 0
    try:
        while not stop.is_set():
            msg = consumer.poll(0.5)
            if msg is None or msg.error():
                continue
            apply(conn, json.loads(msg.value()))
            counters[idx] += 1
            pending += 1
            if pending >= COMMIT_EVERY:
                safe_commit(consumer)
                pending = 0
        safe_commit(consumer)
    finally:
        conn.close()
        consumer.close()


def group_lag(group):
    consumer = make_consumer(group, "lag-probe")
    try:
        partitions = [TopicPartition(TOPIC, p) for p in range(PARTITIONS)]
        total = 0
        for tp in consumer.committed(partitions, timeout=10):
            low, high = consumer.get_watermark_offsets(tp, timeout=10)
            position = tp.offset if tp.offset >= 0 else low
            total += high - position
        return total
    finally:
        consumer.close()


def kafka_cli(*args):
    cmd = [
        "docker", "compose", "exec", "-T", "kafka",
        "/opt/kafka/bin/kafka-consumer-groups.sh",
        "--bootstrap-server", "localhost:9092", *args,
    ]
    done = subprocess.run(cmd, cwd=Path(__file__).parent, capture_output=True, text=True)
    return (done.stdout + done.stderr).strip()


def lag_reporter(mode, group, counters, stop, started):
    started.wait()
    t0 = time.time()
    first = True
    while not stop.wait(3):
        print(f"[{mode}] t={time.time() - t0:4.1f} с  обработано={sum(counters):5d}  lag={group_lag(group)}")
        if first:
            print(kafka_cli("--describe", "--group", group))
            first = False


def run_mode(mode, group=None, reset=True, target=None):
    if reset:
        reset_db()
    group = group or f"grp-{mode}-{int(time.time())}"
    target = target or worker
    stop = threading.Event()
    started = threading.Event()
    counters = [0] * WORKERS
    threads = [
        threading.Thread(target=target, args=(mode, group, stop, counters, i))
        for i in range(WORKERS)
    ]
    reporter = threading.Thread(
        target=lag_reporter, args=(mode, group, counters, stop, started), daemon=True
    )
    for thread in threads:
        thread.start()
    reporter.start()

    waits = Counter()
    samples = 0
    t0 = None
    next_sample = 0.0
    deadline = time.time() + 180
    with psycopg.connect(DSN, autocommit=True) as monitor:
        while time.time() < deadline:
            done = sum(counters)
            now = time.time()
            if done and t0 is None:
                t0 = now
                next_sample = now
                started.set()
            if t0 is not None:
                if done >= EVENTS:
                    break
                if now >= next_sample:
                    for wtype, wevent, count in monitor.execute(WAIT_SQL).fetchall():
                        waits[f"{wtype}/{wevent}"] += count
                    samples += 1
                    next_sample = now + 1
            time.sleep(0.05)
    if t0 is None:
        raise RuntimeError("консьюмеры не получили ни одного сообщения")
    elapsed = time.time() - t0
    stop.set()
    for thread in threads:
        thread.join()
    reporter.join()

    lag = group_lag(group)
    rate = EVENTS / elapsed
    print(f"[{mode}] {EVENTS} событий за {elapsed:.1f} с, {rate:.0f} событий/с, lag после остановки {lag}")
    print(f"[{mode}] ожидания PostgreSQL по {samples} срезам, сессий суммарно")
    for name, count in waits.most_common(4):
        print(f"[{mode}]   {name:28s} {count}")
    with psycopg.connect(DSN) as conn:
        if mode == "ledger":
            rows, total = conn.execute(
                "SELECT count(*), coalesce(sum(amount), 0) FROM payment_ledger"
            ).fetchone()
            print(f"[{mode}] строк в ledger {rows}, сумма {total}, ожидалось {EVENTS} и {TOTAL}")
        else:
            (total,) = conn.execute(
                "SELECT coalesce(sum(pending_amount), 0) FROM merchant_balance"
            ).fetchone()
            print(f"[{mode}] сумма в merchant_balance {total}, ожидалось {TOTAL}")
    return {"mode": mode, "group": group, "seconds": elapsed, "rate": rate, "lag": lag}


def main():
    ensure_topic()
    if topic_size() == 0:
        seed()
    results = [run_mode(mode) for mode in ("hot", "ledger")]
    print("итог")
    for r in results:
        print(f"  {r['mode']:7s} {r['seconds']:6.1f} с  {r['rate']:7.0f} событий/с")


if __name__ == "__main__":
    main()
[hot] t= 3.0 с  обработано=  428  lag=5700
GROUP              TOPIC           PARTITION  CURRENT-OFFSET  LOG-END-OFFSET  LAG             CONSUMER-ID                                HOST            CLIENT-ID
grp-hot-1794784518 payments        2          100             995             895             hot-2-61a9dda9-9bb5-47dd-9bea-43b1040fb3f2 /172.25.0.1     hot-2
grp-hot-1794784518 payments        4          100             1022            922             hot-4-8a6a1104-1e11-4a09-9d6c-0498455bc9e8 /172.25.0.1     hot-4
grp-hot-1794784518 payments        1          150             990             840             hot-1-cb5b9dc1-4723-44f4-9f3e-e1312fb6a6c5 /172.25.0.1     hot-1
grp-hot-1794784518 payments        5          100             1008            908             hot-5-f36b1b54-15a2-4b7e-92b2-dcd70e12aeb3 /172.25.0.1     hot-5
grp-hot-1794784518 payments        3          150             996             846             hot-3-f7a599ea-5598-4fd3-a40a-1276f8da6df3 /172.25.0.1     hot-3
grp-hot-1794784518 payments        0          100             989             889             hot-0-60cc6d7c-7f25-4536-af96-8c403c1d45ed /172.25.0.1     hot-0
[hot] t=10.0 с  обработано= 1358  lag=4800
[hot] t=13.0 с  обработано= 1768  lag=4400
[hot] t=17.0 с  обработано= 2347  lag=3800
[hot] t=21.1 с  обработано= 2885  lag=3250
[hot] t=25.1 с  обработано= 3425  lag=2700
[hot] t=28.2 с  обработано= 3845  lag=2250
[hot] t=31.2 с  обработано= 4273  lag=1900
[hot] t=34.2 с  обработано= 4684  lag=1450
[hot] t=37.2 с  обработано= 5067  lag=1050
[hot] t=40.3 с  обработано= 5451  lag=750
[hot] t=43.3 с  обработано= 5861  lag=300
[hot] 6000 событий за 44.4 с, 135 событий/с, lag после остановки 0
[hot] ожидания PostgreSQL по 45 срезам, сессий суммарно
[hot]   Lock/transactionid           132
[hot]   Client/ClientRead            44
[hot]   Lock/tuple                   35
[hot]   IO/WALSync                   32
[hot] сумма в merchant_balance 23997.00, ожидалось 23997.00
[ledger] t= 3.0 с  обработано= 1120  lag=5100
GROUP                 TOPIC           PARTITION  CURRENT-OFFSET  LOG-END-OFFSET  LAG             CONSUMER-ID                                   HOST            CLIENT-ID
grp-ledger-1794784569 payments        4          350             1022            672             ledger-4-54385e77-1cd8-4ad9-9f12-ba1fe2fc41ea /172.25.0.1     ledger-4
grp-ledger-1794784569 payments        5          350             1008            658             ledger-5-314bd743-dc31-445a-b51b-e2a428851bdf /172.25.0.1     ledger-5
grp-ledger-1794784569 payments        2          350             995             645             ledger-2-e3b38bad-77c2-4eea-849a-79e3ea9dbad2 /172.25.0.1     ledger-2
grp-ledger-1794784569 payments        1          350             990             640             ledger-1-b2c75054-18ad-42ef-a17c-d056c4b72b07 /172.25.0.1     ledger-1
grp-ledger-1794784569 payments        3          350             996             646             ledger-3-4d5c71cd-593e-41fe-8ba4-41fc3b4e263e /172.25.0.1     ledger-3
grp-ledger-1794784569 payments        0          350             989             639             ledger-0-e60ef574-d3d8-4f17-974a-105ebb380b86 /172.25.0.1     ledger-0
[ledger] t= 9.9 с  обработано= 3626  lag=2400
[ledger] t=12.9 с  обработано= 4745  lag=1500
[ledger] t=15.9 с  обработано= 5857  lag=300
[ledger] 6000 событий за 16.6 с, 361 событий/с, lag после остановки 0
[ledger] ожидания PostgreSQL по 17 срезам, сессий суммарно
[ledger]   Client/ClientRead            44
[ledger]   LWLock/WALWrite              37
[ledger]   IO/WALSync                   17
[ledger] строк в ledger 6000, сумма 23997.00, ожидалось 6000 и 23997.00
итог
  hot       44.4 с      135 событий/с
  ledger    16.6 с      361 событий/с
Читать вывод нужно в четыре шага. Сначала сравните строки итога. Затем посмотрите на динамику lag, которую печатает репортёр, и на колонки LAG в выводе kafka-consumer-groups.sh. После этого сверьте срез ожиданий PostgreSQL в двух режимах. Наконец, проверьте, что итоговая сумма и число строк совпали с ожидаемыми.
Заранее посчитаем нижние оценки времени. В режиме hot 3600 событий проходят через одну строку, и по 5 миллисекунд на транзакцию это не меньше 18 секунд. В режиме ledger на каждого из шести консьюмеров приходится около 1000 событий, то есть не меньше 5 секунд. Это только нижние границы, они учитывают одну паузу на событие и ничего больше. Реальное время в прогоне выше. В режиме hot это 44,4 секунды против расчётных 18, то есть в 2,5 раза больше. В режиме ledger это 16,6 секунды против 5, то есть в 3,3 раза больше. Измеренные 135 событий в секунду в режиме hot также ниже расчётного потолка около 330. Прогон не разделяет причины этой разницы. В срезах ожиданий видны Client/ClientRead и IO/WALSync, то есть накладные расходы на коммиты и обмен с клиентом, но их вклад по времени мы не измеряли. Отношение измеренных времён получается делением 44,4 / 16,6 ≈ 2,7 раза, и его нужно читать как результат этого прогона, а не как границу, вытекающую из расчёта.
Прогон ограничен. Он идёт на одном брокере и одной базе на одной машине, а часть времени транзакции занимает моделируемая пауза, а не реальный вызов. Число консьюмеров мы не меняли, везде их шесть на шесть партиций. Поэтому стенд показывает только одно. При шести консьюмерах режим hot в основном прогоне дал 135 событий в секунду (в повторном запуске задания 2 получилось 141), а в срезах ожиданий заметную долю заняли Lock/transactionid и Lock/tuple. Зависимость потолка от числа консьюмеров этот прогон не проверял, о ней говорит только арифметика очереди на одной строке.
Задания
Все решения используют bench.py как библиотеку, поэтому запускаются в том же каталоге, где лежит основной пример.
Задание 1. Время погашения очереди
Запустите шесть консьюмеров в режиме ledger при постоянном притоке около 300 событий в секунду в отдельный топик. Измерьте за окно 5 секунд скорость обработки и фактический приток, посчитайте по формуле время, за которое lag опустится до 500, и сравните с реальным временем.
▶ Решение (нажмите, чтобы открыть)
Скрипт запускает потоковый продюсер и консьюмеров, измеряет R_out и R_in в окне, снимает lag и сравнивает прогноз с реальностью. Порог 500 выбран потому, что закоммиченная позиция отстаёт от реальной на интервал коммита по каждому консьюмеру.
# drain_eta.py · confluent-kafka 2.6.1 · psycopg 3.2.3 · Kafka 4.3.2
import json
import threading
import time

from confluent_kafka import Producer

import bench

bench.TOPIC = "payments_eta"
INFLOW = 300
WINDOW = 5
THRESHOLD = 500


def inflow(stop, sent):
    producer = Producer({"bootstrap.servers": bench.BOOTSTRAP})
    i = bench.EVENTS
    while not stop.is_set():
        for _ in range(INFLOW // 10):
            event = bench.make_event(i)
            producer.produce(bench.TOPIC, key=event["event_id"], value=json.dumps(event))
            i += 1
        sent[0] = i - bench.EVENTS
        producer.poll(0)
        time.sleep(0.1)
    producer.flush(10)


def main():
    bench.ensure_topic()
    if bench.topic_size() == 0:
        bench.seed()
    bench.reset_db()
    group = f"grp-eta-{int(time.time())}"
    stop_workers = threading.Event()
    stop_inflow = threading.Event()
    counters = [0] * bench.WORKERS
    sent = [0]
    workers = [
        threading.Thread(target=bench.worker, args=("ledger", group, stop_workers, counters, i))
        for i in range(bench.WORKERS)
    ]
    for w in workers:
        w.start()
    threading.Thread(target=inflow, args=(stop_inflow, sent), daemon=True).start()

    while sum(counters) == 0:
        time.sleep(0.1)
    t_a, done_a, sent_a = time.time(), sum(counters), sent[0]
    time.sleep(WINDOW)
    t_b, done_b, sent_b = time.time(), sum(counters), sent[0]
    lag_b = bench.group_lag(group)
    t_lag = time.time()

    dt = t_b - t_a
    r_out = (done_b - done_a) / dt
    r_in = (sent_b - sent_a) / dt
    eta = (lag_b - THRESHOLD) / (r_out - r_in) if r_out > r_in else float("inf")
    print(f"R_out={r_out:.0f}/с  R_in={r_in:.0f}/с  lag={lag_b}  прогноз до lag {THRESHOLD}: {eta:.1f} с")

    deadline = time.time() + 120
    while bench.group_lag(group) > THRESHOLD and time.time() < deadline:
        time.sleep(0.5)
    print(f"фактически до lag {THRESHOLD}: {time.time() - t_lag:.1f} с")

    stop_inflow.set()
    stop_workers.set()
    for w in workers:
        w.join()


if __name__ == "__main__":
    main()
R_out=369/с  R_in=300/с  lag=7560  прогноз до lag 500: 102.0 с
фактически до lag 500: 96.2 с
Задание 2. Батч с одним UPDATE на клиента
Перепишите консьюмер так, чтобы он читал пачку до 200 сообщений, суммировал суммы по клиентам и делал один UPDATE на клиента в одной транзакции, а офсет коммитил только после фиксации. Сравните throughput с режимом hot.
▶ Решение (нажмите, чтобы открыть)
Клиенты в транзакции обновляются в отсортированном порядке, чтобы две параллельные транзакции никогда не брали блокировки строк в разном порядке и не создавали взаимную блокировку. Пауза в 5 миллисекунд теперь приходится на батч, а не на событие, и это честная часть выигрыша, потому что стоимость транзакции делится на размер пачки.
# batch_consumer.py · confluent-kafka 2.6.1 · psycopg 3.2.3 · Kafka 4.3.2
import json
import time
from collections import defaultdict
from decimal import Decimal

import psycopg

import bench


def batch_worker(mode, group, stop, counters, idx):
    consumer = bench.make_consumer(group, f"{mode}-{idx}")
    conn = psycopg.connect(bench.DSN, autocommit=True)
    consumer.subscribe([bench.TOPIC], on_revoke=bench.on_revoke)
    try:
        while not stop.is_set():
            messages = consumer.consume(num_messages=200, timeout=0.5)
            batch = [json.loads(m.value()) for m in messages if not m.error()]
            if not batch:
                continue
            sums = defaultdict(Decimal)
            for event in batch:
                sums[event["merchant_id"]] += Decimal(event["amount"])
            with conn.transaction():
                for merchant_id in sorted(sums):
                    conn.execute(
                        "UPDATE merchant_balance SET pending_amount = pending_amount + %s "
                        "WHERE merchant_id = %s",
                        (sums[merchant_id], merchant_id),
                    )
                time.sleep(bench.WORK_MS / 1000)
            bench.safe_commit(consumer)
            counters[idx] += len(batch)
    finally:
        conn.close()
        consumer.close()


def main():
    bench.ensure_topic()
    if bench.topic_size() == 0:
        bench.seed()
    results = [
        bench.run_mode("hot"),
        bench.run_mode("batch", target=batch_worker),
    ]
    print("итог")
    for r in results:
        print(f"  {r['mode']:7s} {r['seconds']:6.1f} с  {r['rate']:7.0f} событий/с")


if __name__ == "__main__":
    main()
[hot] t= 3.0 с  обработано=  431  lag=5700
GROUP              TOPIC           PARTITION  CURRENT-OFFSET  LOG-END-OFFSET  LAG             CONSUMER-ID                                HOST            CLIENT-ID
grp-hot-1794784704 payments        1          100             990             890             hot-1-e33809ed-cd48-4045-a353-8f3826b3476c /172.25.0.1     hot-1
grp-hot-1794784704 payments        0          100             989             889             hot-0-36d0a1da-3a49-468b-9bdb-126853273016 /172.25.0.1     hot-0
grp-hot-1794784704 payments        5          100             1008            908             hot-5-2958baf0-a1db-41c3-8024-a6225882b4a0 /172.25.0.1     hot-5
grp-hot-1794784704 payments        4          100             1022            922             hot-4-be9b6ae4-d651-4d7d-b407-c7b4764dc95e /172.25.0.1     hot-4
grp-hot-1794784704 payments        3          100             996             896             hot-3-914eb589-ad0c-4cde-9a96-e26d23860442 /172.25.0.1     hot-3
grp-hot-1794784704 payments        2          100             995             895             hot-2-8b010ae7-97bc-4856-b7f4-a398083676e0 /172.25.0.1     hot-2
[hot] t= 9.1 с  обработано= 1286  lag=4850
[hot] t=12.1 с  обработано= 1705  lag=4450
[hot] t=15.1 с  обработано= 2131  lag=3950
[hot] t=18.1 с  обработано= 2568  lag=3550
[hot] t=21.2 с  обработано= 2989  lag=3200
[hot] t=24.2 с  обработано= 3414  lag=2700
[hot] t=27.2 с  обработано= 3847  lag=2300
[hot] t=30.2 с  обработано= 4273  lag=1800
[hot] t=33.2 с  обработано= 4692  lag=1500
[hot] t=36.2 с  обработано= 5130  lag=1000
[hot] t=39.2 с  обработано= 5547  lag=550
[hot] t=42.2 с  обработано= 5965  lag=250
[hot] 6000 событий за 42.7 с, 141 событий/с, lag после остановки 0
[hot] ожидания PostgreSQL по 43 срезам, сессий суммарно
[hot]   Lock/transactionid           122
[hot]   Lock/tuple                   45
[hot]   Client/ClientRead            41
[hot]   IO/WALSync                   28
[hot] сумма в merchant_balance 23997.00, ожидалось 23997.00
[batch] 6000 событий за 1.3 с, 4756 событий/с, lag после остановки 0
[batch] ожидания PostgreSQL по 2 срезам, сессий суммарно
[batch]   Lock/transactionid           4
[batch]   Client/ClientRead            1
[batch]   CPU/running                  1
[batch] сумма в merchant_balance 23997.00, ожидалось 23997.00
итог
  hot       42.7 с      141 событий/с
  batch      1.3 с     4756 событий/с
Задание 3. Доказать идемпотентность
Обработайте топик в режиме ledger, затем сбросьте офсеты группы на начало утилитой kafka-consumer-groups.sh с флагом —reset-offsets, прочитайте топик ещё раз и убедитесь, что в ledger нет дубликатов.
▶ Решение (нажмите, чтобы открыть)
Сброс офсетов возможен только для неактивной группы, поэтому скрипт ждёт, пока консьюмеры первого прохода выйдут из группы. Во втором проходе таблицы не пересоздаются, а счётчик обработанных сообщений снова доходит до числа событий, потому что все они прочитаны повторно. Число строк при этом не должно измениться.
# replay.py · confluent-kafka 2.6.1 · psycopg 3.2.3 · Kafka 4.3.2
import time

import psycopg

import bench


def main():
    bench.ensure_topic()
    if bench.topic_size() == 0:
        bench.seed()
    first = bench.run_mode("ledger")
    group = first["group"]
    time.sleep(5)
    print(bench.kafka_cli(
        "--group", group, "--topic", bench.TOPIC,
        "--reset-offsets", "--to-earliest", "--execute",
    ))
    bench.run_mode("ledger", group=group, reset=False)
    with psycopg.connect(bench.DSN) as conn:
        rows, distinct = conn.execute(
            "SELECT count(*), count(DISTINCT event_id) FROM payment_ledger"
        ).fetchone()
    print(f"после повторного чтения строк {rows}, уникальных event_id {distinct}, событий в топике {bench.EVENTS}")


if __name__ == "__main__":
    main()
[ledger] t= 3.0 с  обработано= 1134  lag=5100
GROUP                 TOPIC           PARTITION  CURRENT-OFFSET  LOG-END-OFFSET  LAG             CONSUMER-ID                                   HOST            CLIENT-ID
grp-ledger-1794784764 payments        0          350             989             639             ledger-0-28402b45-a767-4a83-8d60-080f2f61b094 /172.25.0.1     ledger-0
grp-ledger-1794784764 payments        5          350             1008            658             ledger-5-45fbb755-8869-4959-a315-272b18d4e40c /172.25.0.1     ledger-5
grp-ledger-1794784764 payments        4          350             1022            672             ledger-4-68cc2977-7c3c-4ffa-b87e-f8db80b98c05 /172.25.0.1     ledger-4
grp-ledger-1794784764 payments        3          350             996             646             ledger-3-e71400a8-ab94-4bbc-8f0c-47a93512772c /172.25.0.1     ledger-3
grp-ledger-1794784764 payments        2          350             995             645             ledger-2-06f974e8-a2da-4df6-919c-ce8d778ccbc9 /172.25.0.1     ledger-2
grp-ledger-1794784764 payments        1          350             990             640             ledger-1-87b705ff-ff3b-4e20-a8d8-7f6c7db6e09f /172.25.0.1     ledger-1
[ledger] t= 9.8 с  обработано= 3631  lag=2400
[ledger] t=13.8 с  обработано= 5117  lag=900
[ledger] 6000 событий за 16.4 с, 365 событий/с, lag после остановки 0
[ledger] ожидания PostgreSQL по 17 срезам, сессий суммарно
[ledger]   Client/ClientRead            41
[ledger]   LWLock/WALWrite              37
[ledger]   IO/WALSync                   16
[ledger]   CPU/running                  1
[ledger] строк в ledger 6000, сумма 23997.00, ожидалось 6000 и 23997.00
GROUP                 TOPIC           PARTITION  NEW-OFFSET
grp-ledger-1794784764 payments        4          0
grp-ledger-1794784764 payments        3          0
grp-ledger-1794784764 payments        5          0
grp-ledger-1794784764 payments        0          0
grp-ledger-1794784764 payments        2          0
grp-ledger-1794784764 payments        1          0
[ledger] t= 3.0 с  обработано= 2092  lag=4050
GROUP                 TOPIC           PARTITION  CURRENT-OFFSET  LOG-END-OFFSET  LAG             CONSUMER-ID                                   HOST            CLIENT-ID
grp-ledger-1794784764 payments        3          800             996             196             ledger-3-d11a2e44-ee5a-4956-ac6d-1657c36db92c /172.25.0.1     ledger-3
grp-ledger-1794784764 payments        4          800             1022            222             ledger-4-ab206e95-901e-49c4-b232-cd214bd4f151 /172.25.0.1     ledger-4
grp-ledger-1794784764 payments        2          800             995             195             ledger-2-92b2e1ab-679a-44c9-a371-5107ff073926 /172.25.0.1     ledger-2
grp-ledger-1794784764 payments        1          800             990             190             ledger-1-fa15c48b-bb43-4b76-857f-2d15259ea7e2 /172.25.0.1     ledger-1
grp-ledger-1794784764 payments        0          800             989             189             ledger-0-e392289b-894a-4da0-85e3-88333d24145d /172.25.0.1     ledger-0
grp-ledger-1794784764 payments        5          800             1008            208             ledger-5-d3c5843c-6866-4137-ba4b-81df8929c5c7 /172.25.0.1     ledger-5
[ledger] 6000 событий за 8.1 с, 745 событий/с, lag после остановки 0
[ledger] ожидания PostgreSQL по 8 срезам, сессий суммарно
[ledger]   Client/ClientRead            37
[ledger]   CPU/running                  4
[ledger] строк в ledger 6000, сумма 23997.00, ожидалось 6000 и 23997.00
после повторного чтения строк 6000, уникальных event_id 6000, событий в топике 6000
Что дальше
Если вы разрабатываете консьюмеры и хотите уверенно разбираться с офсетами, ребалансировками и гарантиями доставки, разбор этих механизмов с практикой собран в курсе DEVKI: Apache Kafka для разработчиков.
Референсные ссылки
- Документация Apache Kafka 4.3, раздел Design про позицию консьюмера и семантику доставки.
- Документация Apache Kafka 4.3, раздел Monitoring про метрики консьюмера и lag.
- Документация Apache Kafka 4.3, базовые операции про проверку позиции консьюмеров утилитой kafka-consumer-groups.sh.
- Документация PostgreSQL 16, статистика активности про представление
pg_stat_activityи события ожидания.